Générer un fichier XML sur IBM I en RPG Free ILE
La facturation électronique impose aux entreprises de produire des fichiers XML structurés, normalisés, échangés entre plateformes. Pour les équipes qui maintiennent un système de gestion sur IBM i, cela soulève une question concrète : comment générer proprement un fichier XML en RPG Free ILE, alors que le langage est historiquement tourné vers les bases de données DB2 ?
Cet article retrace l’approche mise en œuvre lors d’un projet réel de génération de factures au format Factur-X / CrossIndustryInvoice (norme EN 16931). Au-delà du cas de la facture, la technique décrite vaut pour n’importe quel fichier texte à écrire sur l’IFS : XML, CSV, JSON ou HTML.
Deux mondes à réconcilier
Un développeur RPG passe l’essentiel de son temps dans un environnement bien délimité : des tables DB2, un accès natif ou du SQL intégré, des données encodées en EBCDIC. C’est efficace, robuste et parfaitement adapté à la gestion transactionnelle.
Un fichier XML, lui, appartient à un autre monde. Il vit dans l’IFS (Integrated File System), l’arborescence de type Unix du système. C’est un fichier « stream », attendu par les plateformes de dématérialisation dans un encodage précis : UTF-8. Le défi consiste donc à construire, depuis du code RPG, un fichier texte UTF-8 bien formé et à le déposer au bon endroit de l’IFS.
La bonne nouvelle : le système fournit déjà tout ce qu’il faut. Inutile d’introduire un composant Java ou un utilitaire externe ; les API C standard du système suffisent, et le RPG sait les appeler.
La clé : les API C de l’IFS
Quatre fonctions C couvrent l’ensemble du besoin. On les déclare en prototypes RPG, puis on les utilise comme n’importe quelle procédure.
dcl-pr open int(10) extproc('open');
  path     pointer value options(*string);   // chemin IFS
  oflag    int(10) value;                     // drapeaux d'ouverture
  mode     uns(10) value options(*nopass);    // droits d'accès
  codepage uns(10) value options(*nopass);    // CCSID du fichier
end-pr;

dcl-pr write int(10) extproc('write');
  fd     int(10) value;     // descripteur retourné par open
  buffer pointer value;     // adresse du texte à écrire
  nbytes uns(10) value;     // nombre d'octets à écrire
end-pr;

dcl-pr close int(10) extproc('close');
  fd int(10) value;
end-pr;

dcl-pr unlink int(10) extproc('unlink');  // suppression du fichier
  path pointer value options(*string);
end-pr;
Leur rôle se résume simplement : open crée ou ouvre le fichier et renvoie un identifiant, write y écrit des octets, close libère le fichier, et unlink le supprime si la génération échoue. La seule contrainte de compilation est de lier la directory de service QC2LE (paramètre BNDDIR('QC2LE')).
Trois concepts à maîtriser
Avant d’écrire la moindre balise, trois notions méritent d’être bien comprises, car elles conditionnent la validité du résultat.
- Le file descriptor. L’appel à
openrenvoie un entier, le descripteur de fichier (fd). Cet entier identifie le fichier ouvert ; on le transmet ensuite àwriteet àclose. Une valeur négative signale un échec d’ouverture : il faut systématiquement tester ce cas avant d’écrire quoi que ce soit.
- Le CCSID 1208. Le dernier paramètre de
openindique au système le jeu de caractères du fichier. La valeur 1208 correspond à l’UTF-8, l’encodage attendu pour un XML valide. C’est un point décisif : sans lui, les accents et les caractères spéciaux se retrouvent corrompus, et le fichier est rejeté par la plateforme destinataire.
- Le CRLF. Contrairement à l’écriture dans un fichier base de données, l’IFS ne gère pas les enregistrements pour nous. C’est au programme d’ajouter explicitement le retour chariot suivi du saut de ligne (
x'0D0A') à la fin de chaque ligne, afin d’obtenir un fichier lisible et correctement structuré.
Le cœur du dispositif : une procédure d’écriture
Plutôt que d’appeler write directement à chaque ligne du XML — ce qui serait verbeux et source d’erreurs — on encapsule toute la mécanique dans une procédure unique, appelée ici WriteLine. C’est elle qui sera invoquée des centaines de fois pour construire le document.
dcl-proc WriteLine;
  dcl-pi *n int(10);
    pLine char(2048) const ccsid(1208);
  end-pi;

  dcl-s ligne char(2048) ccsid(1208);
  dcl-s lg    int(10);

  ligne = %trim(pLine) + CRLF;          // ajout du séparateur de ligne
  lg    = %len(%trim(ligne));

  return write(fd : %addr(ligne) : lg); // %addr = adresse du buffer
end-proc;
Deux détails méritent l’attention. D’abord, le tag ccsid(1208) sur le paramètre et sur la variable de travail garantit que le texte manipulé est bien en UTF-8, en cohérence avec le fichier ouvert. Ensuite, write ne raisonne pas en chaînes mais en octets bruts : on lui passe donc un pointeur vers le tampon, obtenu via %addr, accompagné d’une longueur.
Une fois cette procédure en place, le reste du programme devient remarquablement lisible : il ne s’agit plus que d’enchaîner des appels du type WriteLine('<balise>…</balise>').
Ne pas casser le fichier : l’échappement XML
Certains caractères ont une signification syntaxique en XML. Une raison sociale aussi banale que « Durand & Fils » suffit à rendre le fichier invalide si le & n’est pas échappé. Il faut donc remplacer ces caractères réservés par leurs entités correspondantes.
dcl-proc escapeXml;
dcl-pi *n varchar(2048);
pTexte varchar(2048) const;
end-pi;
dcl-s r varchar(2048);
r = pTexte;
r = %scanrpl('&' : '&' : r); // à traiter EN PREMIER
r = %scanrpl('<' : '<' : r);
r = %scanrpl('>' : '>' : r);
r = %scanrpl('"' : '"' : r);
r = %scanrpl('''' : ''' : r);
return r;
end-proc;L’ordre des remplacements n’est pas anodin : le & doit impérativement être traité en premier. Dans le cas contraire, les & introduits par les substitutions suivantes (<, >…) seraient eux-mêmes ré-échappés, produisant des séquences erronées. Cette fonction s’applique à toute donnée de texte libre : libellés d’articles, raisons sociales, désignations, commentaires.
Un exemple complet et minimal
Le programme ci-dessous rassemble les éléments précédents en une démonstration autonome. Il ouvre un fichier, écrit une petite facture, puis ferme le descripteur. C’est le squelette exact que l’on retrouve, démultiplié, dans un programme de production.
**free
///
// @Program DEMOXML
// @Purpose Démonstration minimale : créer un fichier XML sur l'IFS en RPG Free
//
// Le principe :
// 1) open() -> on crée/ouvre un fichier "stream" sur l'IFS en UTF-8
// 2) write() -> on écrit le contenu ligne par ligne
// 3) close() -> on ferme le descripteur
//
///
ctl-opt dftactgrp(*no) actgrp(*new) bnddir('QC2LE');
// ---------------------------------------------------------------------------
// 1. PROTOTYPES DES API C DE L'IFS
// ---------------------------------------------------------------------------
dcl-pr open int(10) extproc('open');
path pointer value options(*string); // chemin IFS (ex: /tmp/fic.xml)
oflag int(10) value; // drapeaux d'ouverture
mode uns(10) value options(*nopass); // droits d'accès (rwx)
codepage uns(10) value options(*nopass); // CCSID du fichier (1208 = UTF-8)
end-pr;
dcl-pr write int(10) extproc('write');
fd int(10) value; // descripteur retourné par open
buffer pointer value; // adresse du texte à écrire
nbytes uns(10) value; // nombre d'octets à écrire
end-pr;
dcl-pr close int(10) extproc('close');
fd int(10) value;
end-pr;
dcl-pr unlink int(10) extproc('unlink'); // suppression du fichier
path pointer value options(*string);
end-pr;
// ---------------------------------------------------------------------------
// 2. CONSTANTES D'OUVERTURE (drapeaux open + droits + séparateur de ligne)
// ---------------------------------------------------------------------------
dcl-c O_WRONLY 2; // écriture seule
dcl-c O_CREAT 8; // créer le fichier s'il n'existe pas
dcl-c O_TRUNC 64; // remettre à 0 octet (écrasement)
dcl-c O_TEXTDATA 16777216; // mode texte (conversion CCSID)
dcl-c CCSID_UTF8 1208; // UTF-8 -> indispensable pour le XML
dcl-c MODE_RWX 448; // droits rwx pour le propriétaire
dcl-c CRLF x'0D0A'; // retour chariot + saut de ligne
// ---------------------------------------------------------------------------
// 3. VARIABLES
// ---------------------------------------------------------------------------
dcl-s fd int(10);
dcl-s rc int(10);
dcl-s chemin varchar(256);
// ===========================================================================
// PROGRAMME PRINCIPAL
// ===========================================================================
chemin = '/tmp/demo_facture.xml';
// --- ÉTAPE 1 : ouverture / création du fichier en UTF-8 -------------------
fd = open( %trim(chemin)
: O_WRONLY + O_CREAT + O_TRUNC + O_TEXTDATA // drapeaux combinés
: MODE_RWX // droits
: CCSID_UTF8 ); // 1208 = UTF-8
if fd < 0; // < 0 => échec de l'ouverture
*inlr = *on;
return;
endif;
// --- ÉTAPE 2 : écriture du XML ligne par ligne ----------------------------
WriteLine('<?xml version="1.0" encoding="UTF-8"?>');
WriteLine('<Facture>');
WriteLine(' <Numero>FA-2026-001</Numero>');
WriteLine(' <Client>' + escapeXml('Durand & Fils') + '</Client>');
WriteLine(' <Montant devise="EUR">1250.00</Montant>');
WriteLine('</Facture>');
// --- ÉTAPE 3 : fermeture du descripteur ------------------------------------
rc = close(fd);
*inlr = *on;
return;
// ===========================================================================
// PROCÉDURE RÉUTILISABLE : écrit UNE ligne de texte + saut de ligne
// Le buffer est tagué ccsid(1208) : le texte est donc bien en UTF-8.
// ===========================================================================
dcl-proc WriteLine;
dcl-pi *n int(10);
pLine char(2048) const ccsid(1208);
end-pi;
dcl-s ligne char(2048) ccsid(1208);
dcl-s lg int(10);
ligne = %trim(pLine) + CRLF; // on ajoute le séparateur de ligne
lg = %len(%trim(ligne));
return write(fd : %addr(ligne) : lg); // %addr = adresse du buffer
end-proc;
// ===========================================================================
// PROCÉDURE : échappement des caractères spéciaux du XML
// ATTENTION : remplacer '&' EN PREMIER, sinon double échappement.
// ===========================================================================
dcl-proc escapeXml;
dcl-pi *n varchar(2048);
pTexte varchar(2048) const;
end-pi;
dcl-s r varchar(2048);
r = pTexte;
r = %scanrpl('&' : '&' : r); // & EN PREMIER
r = %scanrpl('<' : '<' : r);
r = %scanrpl('>' : '>' : r);
r = %scanrpl('"' : '"' : r);
r = %scanrpl('''' : ''' : r);
return r;
end-proc;Le fichier produit est un XML standard, où la raison sociale a bien été échappée :
<?xml version="1.0" encoding="UTF-8"?>
<Facture>
<Numero>FA-2026-001</Numero>
<Client>Durand & Fils</Client>
<Montant devise="EUR">1250.00</Montant>
</Facture>Du squelette au cas réel
La génération d’une vraie facture électronique repose exactement sur ce principe, mais à une autre échelle. Une boucle SQL parcourt les factures à traiter ; pour chacune, les données sont chargées dans des structures externes (entête, parties prenantes, lignes d’articles, ventilation de TVA, pied de facture) ; puis des dizaines d’appels à WriteLine reconstituent l’arborescence CrossIndustryInvoice. Chaque valeur y est associée à son code métier normalisé — BT-1 pour le numéro de facture, BT-112 pour le montant total TTC, et ainsi de suite. La complexité réside alors dans la conformité à la norme, non dans la mécanique d’écriture, qui reste celle décrite ici.
Bonnes pratiques
Quelques principes, issus de l’expérience, font la différence entre une preuve de concept et un programme fiable en production :
- Tester le code retour de
open. Un descripteur négatif signale un échec ; il ne faut pas tenter d’écrire dans un fichier qui n’a pas pu être ouvert. - Toujours fermer le descripteur. Un
fdlaissé ouvert peut verrouiller le fichier ou produire un contenu incomplet. - Nettoyer en cas d’erreur. Lorsqu’une exception interrompt la génération,
unlinksupprime le fichier partiellement écrit, évitant de livrer un XML tronqué. - Assurer la cohérence UTF-8. Le tag
ccsid(1208)du tampon et le CCSID passé àopendoivent concorder. - Centraliser l’écriture. Une procédure
WriteLineunique rend le code lisible, réduit les risques d’erreur et facilite la maintenance. - Échapper tout texte libre. Les données saisies par les utilisateurs doivent systématiquement passer par la fonction d’échappement avant d’être insérées dans une balise.
Conclusion
Générer du XML sur IBM i en RPG Free ILE ne requiert ni bibliothèque tierce ni changement de paradigme. Trois idées suffisent à poser des fondations solides : les API C de l’IFS (open, write, close, unlink) assurent l’écriture de tout fichier texte ; le CCSID 1208 garantit un encodage UTF-8 conforme ; et une procédure d’écriture associée à une fonction d’échappement rendent le code clair et maintenable. Le reste relève du métier — remplir les bonnes balises avec les bonnes données.
Cette approche, éprouvée dans le cadre de la facturation électronique, constitue une brique réutilisable pour tout besoin d’interopérabilité par fichiers structurés sur la plateforme IBM i.
Récupérer le SQL d’un QRY avec RTVQMQRY
Vous avez un ancien objet *QRY sur votre IBM i et vous souhaitez retrouver la requête SQL correspondante ?
La commande RTVQMQRY permet de récupérer la requête d’un objet Query et de la restituer sous forme de source SQL.
Petit exemple :
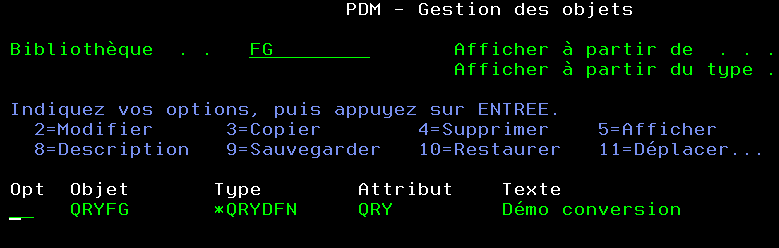
Lancement de la commande de récupération
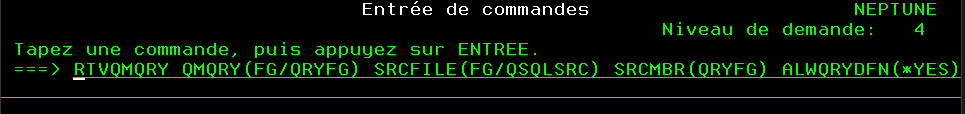
Résultat :
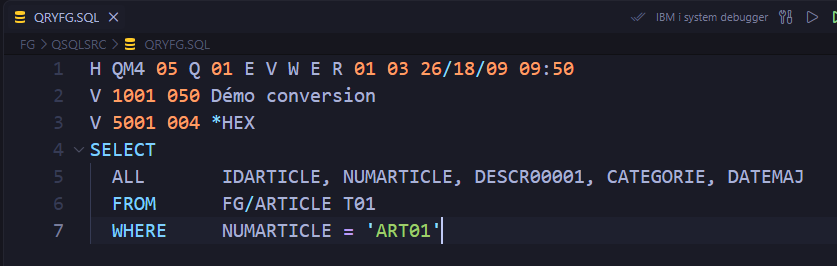
Commande :
RTVQMQRY QMQRY(FG/QRYFG) SRCFILE(FG/QSQLSRC) SRCMBR(QRYFG) ALWQRYDFN(*YES)Le résultat peut ensuite être consulté ou retravaillé comme du SQL.
C’est particulièrement utile lorsqu’on intervient sur un ancien patrimoine IBM i et que l’on souhaite :
- comprendre une requête existante ;
- retrouver sa logique SQL ;
- documenter un traitement ;
- préparer sa migration vers SQL.
Une commande IBM i assez méconnue, mais très pratique lorsqu’on doit faire parler un ancien objet Query.
De Lyon à l’IBM i : quand les cartes perforées tissent encore notre code
La semaine dernière, à Lyon, lors du congrès Common Europe 2026, nous avons parlé modernisation, APIs, IA… et futur de l’IBM i.
Mais au détour des conversations, difficile d’oublier une évidence :
une partie de notre ADN technologique est née ici même, à Lyon.
Et si les développeurs RPG d’aujourd’hui partageaient, sans toujours le savoir, un héritage direct avec les canuts et les métiers Jacquard ?
Lyon, berceau d’une révolution : le métier Jacquard
Au début du XIXe siècle, Lyon est la capitale mondiale de la soie. Les métiers à tisser sont complexes, coûteux et surtout… difficiles à piloter.
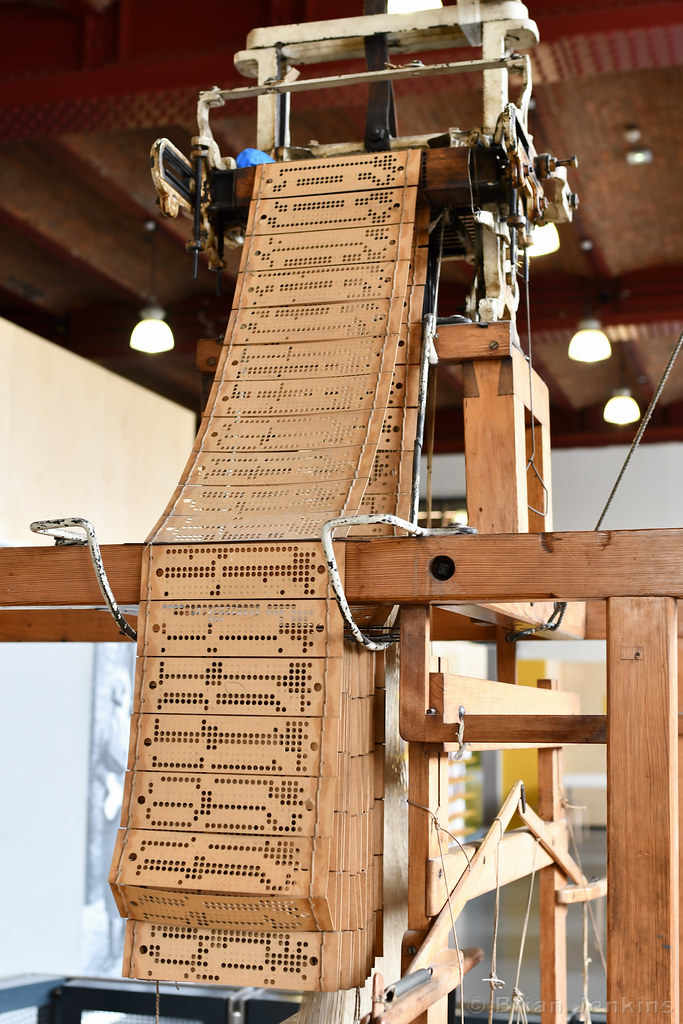
En 1801, Joseph Marie Jacquard introduit une innovation majeure : un métier à tisser contrôlé par des cartes perforées.
Chaque carte représente une ligne du motif à tisser. Les trous dictent mécaniquement quelles aiguilles doivent être activées.
C’est simple, robuste, et surtout :
- programmable
- reproductible
- automatisable
Autrement dit : le premier système programmable industriel de l’histoire.
Napoléon, sponsor inattendu du “code”
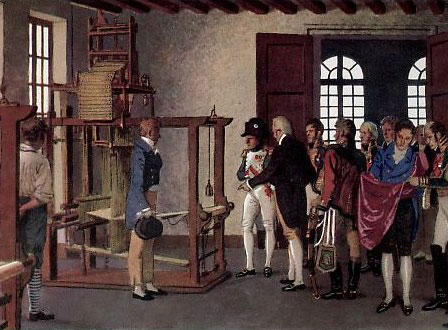
Le métier Jacquard n’a pas été immédiatement accepté. Les canuts voyaient cette innovation comme une menace pour leur savoir-faire… et certains métiers ont même été détruits. C’est finalement Napoléon Bonaparte qui a soutenu Jacquard et officialisé l’usage de sa machine.
On pourrait presque dire que l’histoire de la “programmation” a démarré avec :
- une innovation disruptive
- une résistance des utilisateurs
- et un sponsor politique pour imposer le changement
Un schéma… encore très actuel ?
La carte perforée : premier support de programmation
Le principe est fondamental :
L’information n’est plus dans la machine, elle est dans un support externe.
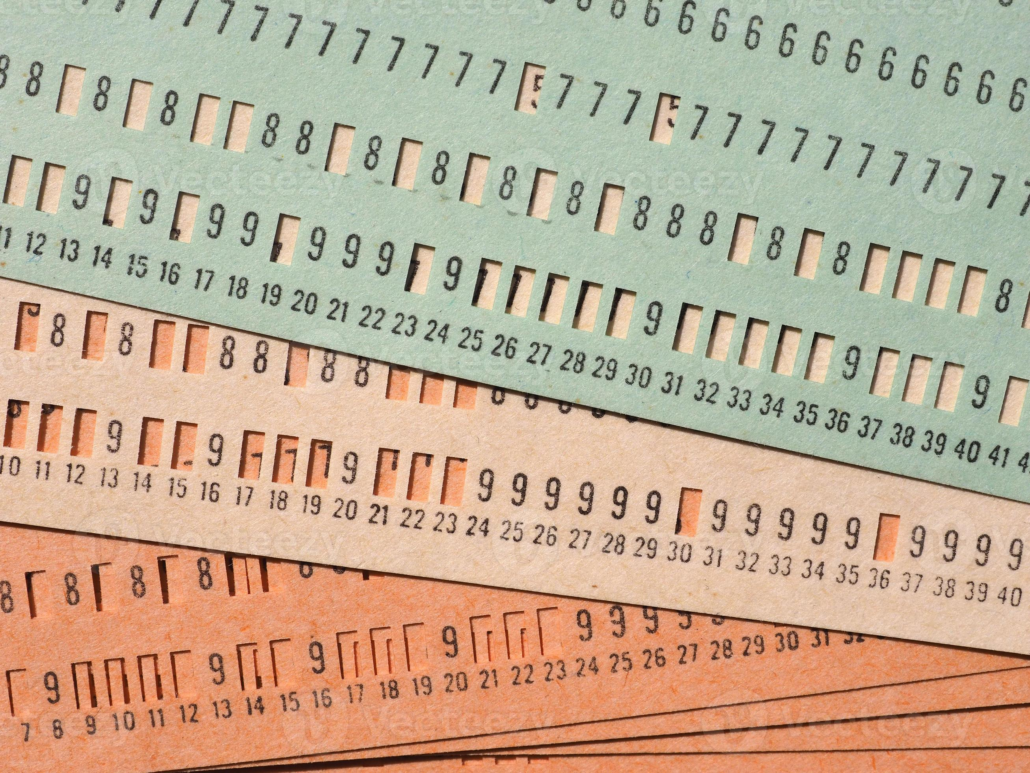
Chaque trou correspond à une instruction binaire :
- trou → action
- pas de trou → pas d’action
Ce modèle va traverser les décennies et inspirer directement les premiers systèmes informatiques.
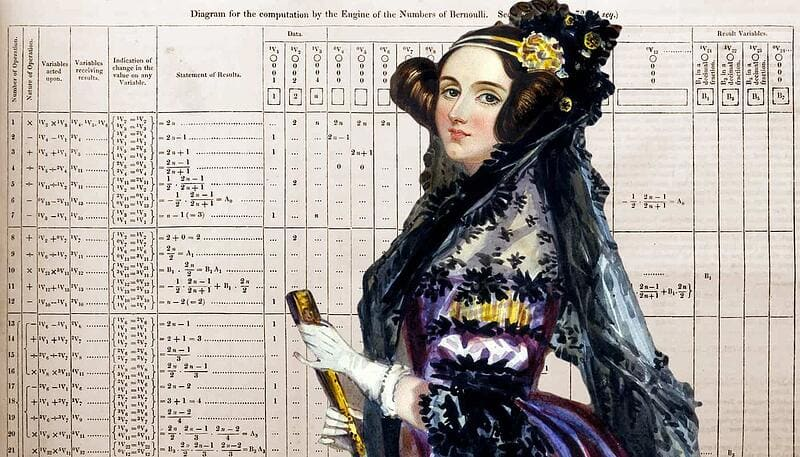
Ada Lovelace avait déjà compris
Au XIXe siècle, Charles Babbage conçoit sa “machine analytique”, ancêtre de l’ordinateur.
Son idée ? Utiliser… des cartes perforées inspirées directement du métier Jacquard.
Et Ada Lovelace, souvent considérée comme la première développeuse de l’histoire, va encore plus loin. Elle comprend que la machine pourrait manipuler autre chose que des chiffres.
Elle écrit, en substance :
“La machine pourrait composer de la musique si on lui donnait les règles.”
Autrement dit : la programmation n’était déjà plus une question de calcul, mais de logique et de création.
Du textile au numérique : l’héritage IBM
IBM industrialise massivement l’usage des cartes perforées au XXe siècle.
Le RPG : un langage façonné par les cartes
Le langage RPG, introduit dans les années 1960, est directement conçu pour… les cartes perforées.
Chaque ligne de code correspond à une carte. Chaque colonne a une signification précise.
Exemple :
- colonnes 1–5 : libre
- colonne 6 : type de ligne
- reste : spécifications
Ce format n’est pas une contrainte arbitraire, c’est un héritage physique.
Une histoire de continuité
Nous n’avons pas changé de paradigme
Nous avons changé de support
Du métier Jacquard à l’IBM i :
- on programme
- on structure
- on exécute
Conclusion : coder, c’est tisser
À Lyon, pendant le Congrès de Common Europe, difficile de ne pas voir le parallèle :
Les développeurs IBM i sont les héritiers des canuts !
Et au fond, nous faisons le même métier : Transformer des instructions en valeur.
Html vers pdf dans l’IBM i
Aujourd’hui vous verrez comment créer un programme capable de convertir un fichier html en PDF depuis votre IBM i à l’aide d’un appel d’API externe.
Rappel sur l’IBMi vous pouvez générer du PDF en utilisant :
- Transform Services produit sous licence IBM mais très sommaire
- Une solution open source que vous installez sur votre partition
Exemple:
wkhtmltopdf (outil de conversion) qui n’est en fait plus du tout maintenu.
On va donc présenter une autre solution qui se base sur les API
Nous avons choisi l’API qui s’appelle PDFSPARK.
Cette solution vous permet de tester notre outil, vous avez jusqu’à 20 requêtes/minute sans clé alors que la plupart des autres API demandent une inscription et proposent environ que 15 requêtes/jour avec un forfait gratuit.
Normalement l’API reçoit une page en ligne en html puis la convertie, mais ici on voulait un .html depuis l’IFS donc j’ai demandé à l’IA (claude) de me faire juste un mini programme pour l’utiliser avec un fichier local et il m’a donné ça :
#!/QOpenSys/usr/bin/bash

export PATH=/QOpenSys/pkgs/bin:/QOpenSys/usr/bin:/usr/bin:$PATH

HTML_FILE=$(echo -n "$1" | tr -d ' ')
PDF_FILE="${HTML_FILE%.html}.pdf"

if [ ! -f "$HTML_FILE" ]; then
    echo "ERROR: HTML file not found"
    exit 1
fi

HTML_CONTENT=$(cat "$HTML_FILE" | jq -Rs .)

curl -s -X POST "https://pdfspark.dev/api/v1/pdf/from-html" \
  -H "Content-Type: application/json" \
  -d "{\"html\": $HTML_CONTENT, \"options\": {\"format\": \"A4\"}}" \
  -o "$PDF_FILE"

echo "DONE : $PDF_FILE"
echo "Your file is located in : $HTML_FILE"
Le programme fait, dans l’ordre :
- Récupère le chemin du fichier à convertir en paramètre
- Crée un PDF du même nom (que le nom du fichier)
- Vérifie si le fichier existe vraiment
- Lis le .html passé en paramètre et le converti en JSON pour ensuite l’injecter dans l’API (
jq -Rs) - Et ensuite la requête curl donnée par le site de l’API
Puis il y a le programme CL qui appelle le .sh depuis 5250 :
PGM PARM(&FILE)

/* début de la construction de la commande bash */
DCL  VAR(&NULL)     TYPE(*CHAR) LEN(1)   VALUE(X'00')

DCL  VAR(&BASH)     TYPE(*CHAR) LEN(100) +
     VALUE('/QOpenSys/usr/bin/bash')

DCL  VAR(&CONVERT)  TYPE(*CHAR) LEN(100) +
     VALUE('/chemin/vers/votre/fichier/html2pdf.sh')
/* fin de la construction de la commande bash */

/* Création de la variable FILE pour rentrer en paramètre
le chemin vers le fichier à convertir depuis 5250 */
DCL  VAR(&FILE)     TYPE(*CHAR) LEN(256)
DCL  VAR(&FILETRIM) TYPE(*CHAR) LEN(100)

               /* concaténation des variables
               pour former la commande bash final */
                CHGVAR VAR(&FILETRIM) VALUE(&FILE)
                CHGVAR VAR(&BASH)     VALUE(&BASH     *TCAT &NULL)
                CHGVAR VAR(&CONVERT)  VALUE(&CONVERT  *TCAT &NULL)
                CHGVAR VAR(&FILETRIM) VALUE(&FILETRIM *TCAT &NULL)

                /*Appel de QP2SHELL pour l'exécution de la commande*/
                CALL PGM(QP2SHELL) PARM(&BASH &CONVERT &FILETRIM)

ENDIT:
ENDPGM
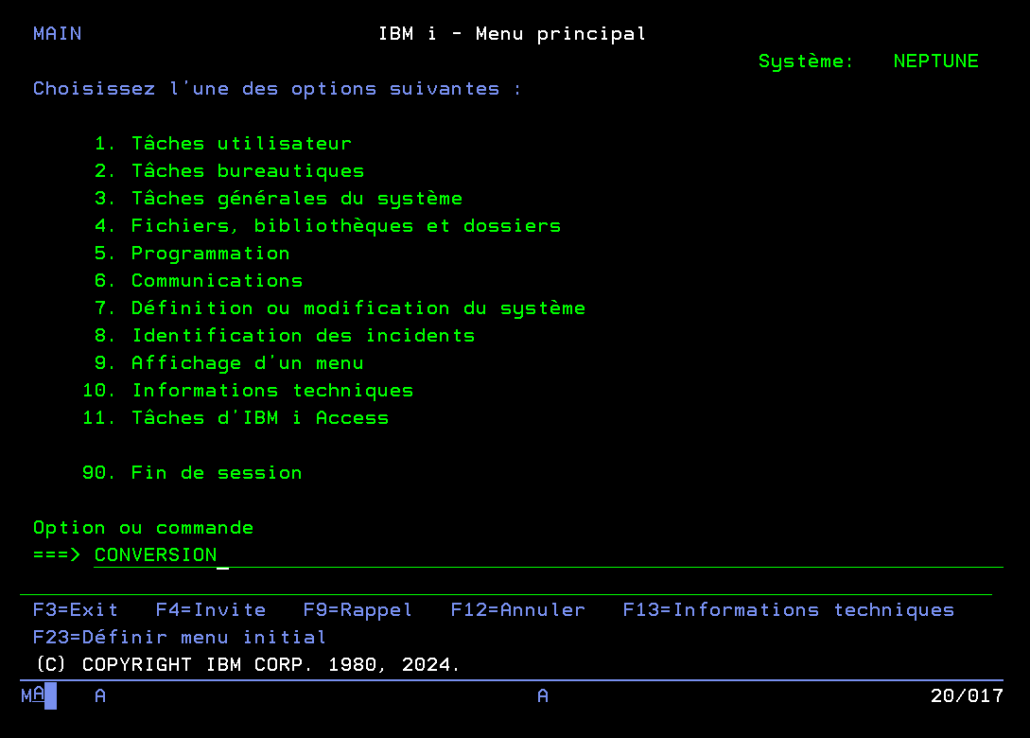
Après compilation et ajout de la librairie, il suffit d’appeler ce programme via l’interface 5250 avec en paramètre le chemin vers le fichier .html que vous voulez convertir en PDF :
==>CALL CONVERSION PARM('/chemin/vers/fichier.html')
Pour l’instant, le nouveau fichier .PDF sera enregistré au même endroit que le .html
Et pour vous faciliter encore plus la tâche,
vous pouvez créer une commande à appeler depuis 5250 en créant un fichier CONVERSION.CMD comme ceci :
             CMD        PROMPT('Conversion html vers pdf')
             PARM       KWD(FICHIER) TYPE(*CHAR) LEN(256) MIN(1) +
                          PROMPT('Fichier à convertir')
puis la compiler.
Au final
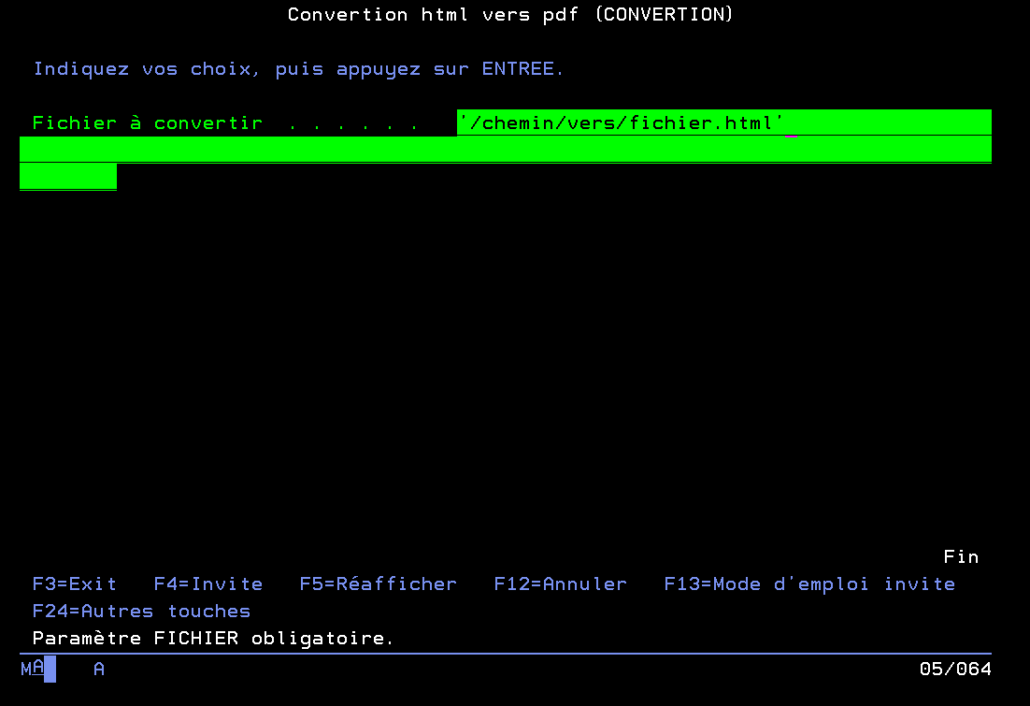
Vous pourrez appeler votre programme de conversion depuis 5250 juste avec la commande : conversion puis en appuyant sur F4, tomber sur cet écran qui vous permettra de renseigner (entre simple quote ‘ ) le chemin vers le fichier à convertir (également utilisable en batch):
Remarques :
Votre IBMi devra sortir vers l’URL https://pdfspark.dev sur le port 443 , ou vers le provider que vous aurez choisi
Vous pourrez faire des PDF plus évolués que par Transformer, et il est assez facile de générer du HTML.
Vous devrez choisir votre partenaire surtout si vous voulez traiter des données confidentielles
Ici nous avons choisi de faire du CURL , mais vous pouvez utiliser si vous le préférez un programme SQLRPGLE
Vous pouvez bien sur améliorer ce code à votre guise.
IBM i en 2026 : la pénurie de compétences, une réalité désormais impossible à ignorer
En 2026, un fait majeur ressort du IBM i Marketplace Survey : la pénurie de compétences IBM i devient la préoccupation n°1, devant la cybersécurité, pour la première fois en presque dix ans.
Les départs à la retraite s’accélèrent, les équipes se réduisent, les projets se complexifient… et le renouvellement est insuffisant. Pourtant, tout n’est pas sombre : l’écosystème évolue, de nouvelles approches émergent, et certains pays — comme la France — disposent d’atouts uniques pour former rapidement.
Un départ massif des experts… et un vivier insuffisant pour les remplacer
La démographie joue contre les organisations : une large majorité des spécialistes IBM i ont plus de 50 ans, beaucoup étant déjà partis ou proches de la retraite. Pendant ce temps, le monde académique continue d’ignorer RPG et IBM i.
Résultat :
- une perte d’expertise métier cumulée,
- des applications critiques peu documentées,
- et un risque croissant de dépendance à un ou deux profils clés.
Cette situation explique pourquoi 69 % des entreprises déclarent la compétence IBM i comme souci majeur.
La France dispose pourtant d’un avantage rare pour former rapidement
Sans trop appuyer le trait, il faut reconnaître un point souvent méconnu : la France bénéficie d’un écosystème particulièrement performant pour former rapidement de nouveaux talents. Nous profitons en effet d’un ensemble de dispositifs privés et publics qui, fait notable, savent travailler en synergie.
Les POEI, organisées depuis plus de dix ans sous de multiples formats, en sont une illustration concrète : elles permettent de financer une formation ciblée avant embauche pour répondre à un besoin métier précis. S’y ajoutent un foisonnement d’initiatives autour de l’alternance, ainsi qu’une offre de formation professionnelle soutenue par les OPCO, qui facilite la montée en compétences sur des technologies spécifiques.
Cet ensemble de mécanismes donne aux entreprises la possibilité de former un candidat avant embauche afin de combler un écart de compétences — une approche parfaitement alignée avec les réalités IBM i, où l’on privilégie depuis longtemps la montée en compétences plutôt que la quête du “profil idéal introuvable”.
On observe toutefois une absence notable de formations institutionnelles (lycées professionnels, BUT, universités, écoles d’informatique) portant sur IBM i ou RPG. Cela limite naturellement la visibilité du domaine auprès des jeunes.
Cela ne règle pas tout, mais c’est un avantage concret pour les organisations françaises qui souhaitent attirer et intégrer de nouveaux talents dans l’écosystème IBM i.
Quand l’IA ralentit l’entrée des jeunes dans l’IT… y compris sur IBM i
Un autre phénomène joue en arrière‑plan en 2026 : l’IA fait baisser les embauches juniors dans l’ensemble du secteur IT.
Selon Korn Ferry, 37 % des entreprises prévoient de remplacer des postes d’entrée de carrière par l’IA. Gartner observe la même tendance : les entreprises recourent davantage à l’IA pour les tâches “low value”, ce qui réduit mécaniquement les opportunités d’entrée des jeunes diplômés.
Sans dramatiser, cela signifie que :
- le renouvellement naturel des compétences pourrait ralentir,
- les experts actuels deviennent encore plus stratégiques,
- et il sera mécaniquement plus difficile de les remplacer lorsqu’ils partiront.
Pour IBM i, déjà confronté à un déficit de nouveaux talents, cet effet secondaire de l’IA mérite d’être surveillé.
Mais où sont les “centaines” ou “milliers” de postes IBM i dont on parle ?
La question revient souvent, et elle est légitime : si les besoins sont si énormes, pourquoi ne voit‑on pas une avalanche d’offres d’emploi IBM i ?
Quelques éléments de réponse — sans exagération :
1. Un besoin réel mais très fragmenté
Les organisations IBM i fonctionnent souvent avec de petites équipes (3–5 personnes), un modèle stable depuis des années selon la Marketplace Survey.
Elles recrutent surtout au fil des départs, pas par vagues massives.
2. Un marché qui “tient” avec ce qu’il a
Les entreprises retardent les modernisations, réorganisent en interne, externalisent ponctuellement ou repoussent le recrutement.
Le marché de l’emploi IBM i montre d’ailleurs une embauche lente, malgré la hausse des salaires, comme observé dans les analyses emploi de 2024–2025.
3. Une demande qui change de nature
Les entreprises ne cherchent plus seulement des “développeurs RPG”, mais des profils capables de :
- faire du Git,
- moderniser le code,
- exposer des API,
- intégrer des outils open source ou cloud.
La demande existe, mais elle est hybride, moins visible, et souvent absorbée par de la prestation.
4. Une partie du besoin est transférée vers des MSP ou vers le cloud
Le survey 2026 montre une montée du cloud et des providers de services, utilisés pour déporter une partie des responsabilités (maintenance, HA/DR, sécurité).
Cela réduit mécaniquement le volume d’offres en direct.
Conclusion : un vrai défi… mais aussi une fenêtre d’opportunité
L’écosystème IBM i fait face à une équation complexe :
- Une pénurie de compétences reconnue et mesurée (69 % des organisations).
- Une dynamique mondiale où l’IA réduit les postes juniors, freinant l’arrivée des nouveaux talents.
- Une demande réelle mais diffuse, structurée par du remplacement plutôt que du recrutement massif.
Pour autant, les solutions existent :
- programmes de formation internes,
- mentorat et documentation,
- modernisation technique,
- et, en France, un atout concret avec la POEI qui permet d’intégrer et de former des jeunes profils rapidement.
La plateforme IBM i reste robuste, moderne et stratégique. Désormais, l’enjeu est clair : organiser le renouvellement des compétences plutôt que l’attendre.
Nous avons bien d’autres thèmes à prendre en compte, comme une communauté active et engagée, mais nous en reparlerons !
Parlez REXX sur IBMi
REXX (Restructured Extended Executor) est un langage de script interprété créé par IBM, bien connu pour les « Roger » qui ont sévit sous OS2.
Il est conçu pour être facile à lire et facile à apprendre, tout en étant très puissant pour l’automatisation.
Sur IBMi, il est utilisé pour :
Automatiser des tâches système
Créer des utilitaires interactifs
Prototyper rapidement
Faire du traitement de texte et de données
Ces points forts sont :
Très rapide à écrire, idéal pour du scripting jetable
Permet d’appeler directement des commandes système sans compiler un programme
Peut servir de « colle » entre RPG, CL, SQL et PASE/QShell
Permet de faire des tests d’appels, des scripts de migration, des reprises de données.
Comment ca marche?
Vous devez créer un fichier source qui contiendra les scripts à exécuter
CRTSRCPF FILE(MALIB/QRXSRC) RCDLEN(112) TEXT(‘Sources REXX’)
Vous devez saisir vos scripts ici REXX01
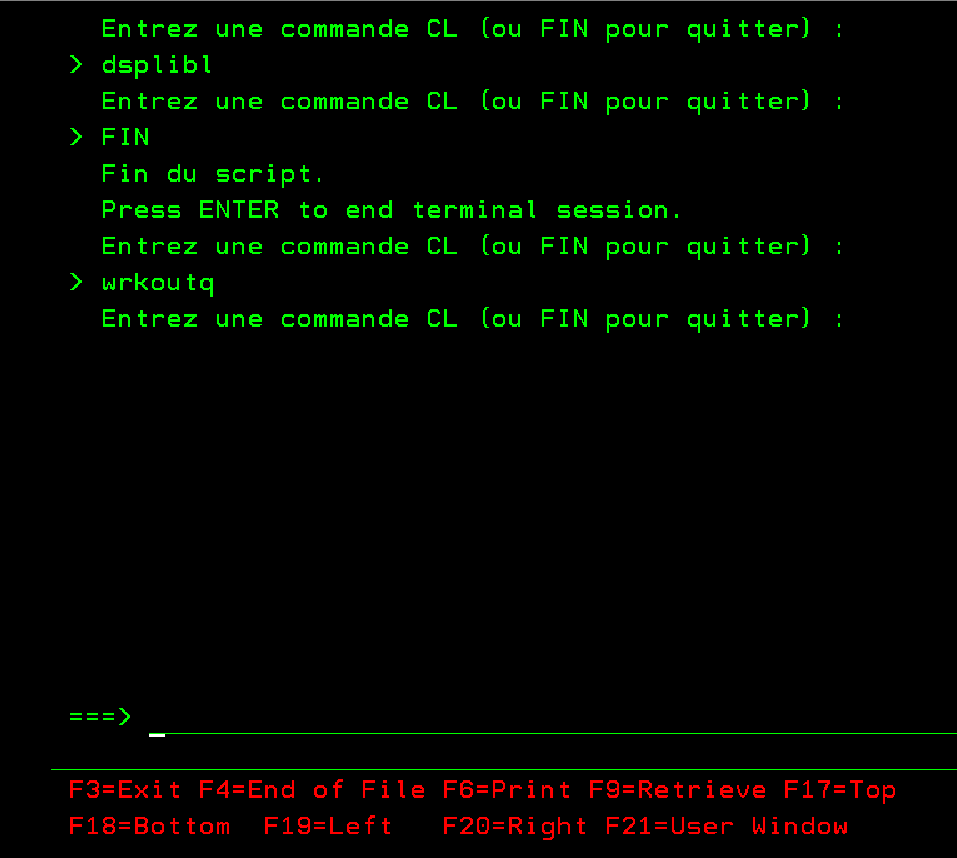
/* REXX / / Boucle interactive jusqu’à ce que l’utilisateur tape ‘FIN’ */
DO FOREVER
SAY « Entrez une commande CL (ou FIN pour quitter) : »
PULL CMD
IF CMD = « FIN » THEN LEAVE
ADDRESS ‘COMMAND’ CMD
END
Ce scripte exécutera des commandes CLP, jusqu’à ce que saisissiez FIN
Pour exécuter ce script :
STRREXPRC SRCMBR(REXX01) SRCFILE(MALIB/QRXSRC)
Remarque :
Le rexx est de moins en moins utilisé mais, il peut encore être utilisé, en effet, il peut aider a du déploiement et de la mise au point, etc…
Pour en savoir plus :
https://en.wikipedia.org/wiki/Rexx
Merci à Dilhan pour sa contribution
Les profils _NC en V7R6
En V7R6 vous avez de nouveaux profils qui apparaissent avec l’extention _NC
QPGMR_NC
QSECOFR_NC
QSYSOPR_NC
QUSER_NC
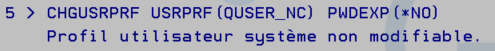
C’est des profils qui ne sont pas modifiables, et ils n’ont pas de mot de passe
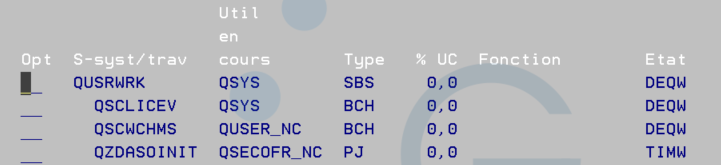
Et certains services ibm démarrent avec ceux ci
Conclusions :
Attention, par exemple, si vous avez customisé QUSER ou QPGMR vous pouvez avoir des surprises après migration