Souvent, quand on veut faire une recherche sur les utilisateurs, on utilise la vue USER_INFO de QSYS2 , mais il existe une vue simplifiée USER_INFO_BASIC qui dans 90% des cas suffit.
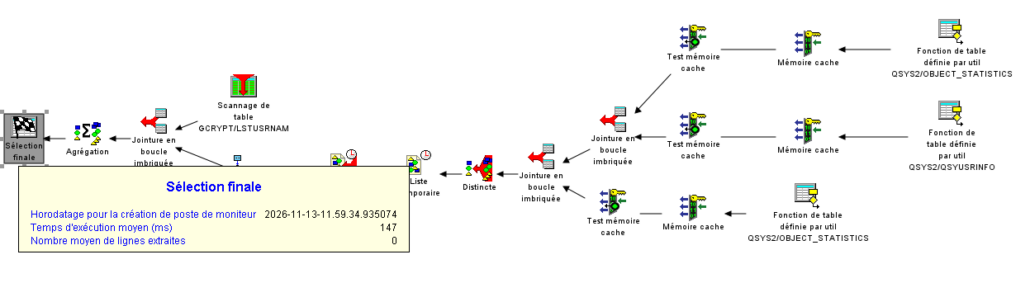
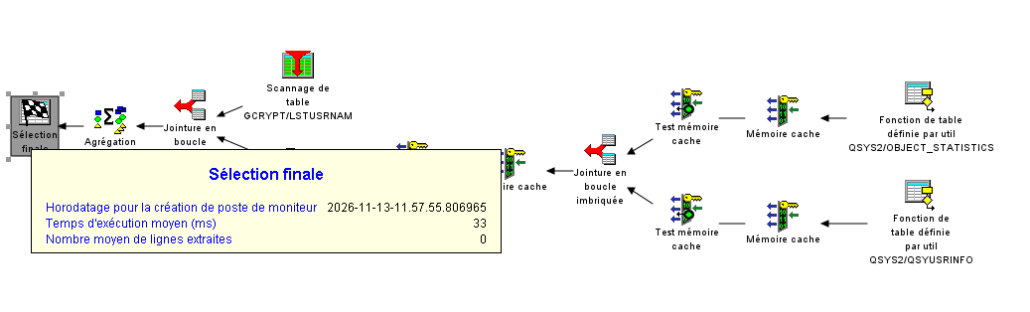
On à soumis à Visual_explain les 2 requêtes qu’on utilise dans notre application pour comparer les résultats
USER_INFO
USER_INFO_BASIC
Conclusion :
On voit bien que le service SQL ne déclenche pas la même chose …
et sur une simple requête on passe d’un temps moyen de 33 à 147 ms c’est plus de 4 fois !
Du coup, on vous conseille d’utilisez au maximum la vue simplifiée sur de gros traitement le gain est énorme
Vous voyez que vos vues accèdent à une fonction table QSYS2.QSYUSRINFO
Cette fonction table est beaucoup moins documentée, mais elle est utilisable directement et plus performante
SELECT * FROM TABLE ( QSYS2.QSYUSRINFO(‘PLB’) ) AS U;
Ou même avec le paramètre BASIC qui suffit souvent
SELECT * FROM TABLE ( QSYS2.QSYUSRINFO(‘PLB’ ‘BASIC’) ) AS U;
d’après mes tests 2 fois plus rapide !
Scott Forstie confirme que les fonctions sous-jacentes de ces services peuvent être interrogées directement.
Évitez simplement de présumer que leurs colonnes sont identiques à celles des vues, les vues sont préparées pour être plus lisible.
L’Analyse des indexs consiste souvent à analyser -Les indexs qui manquent, ou les MTI crées -Les indexs inutilisés
Mais il faut aussi analyser -Les indexs Invalides -Les indexs à reconstruire
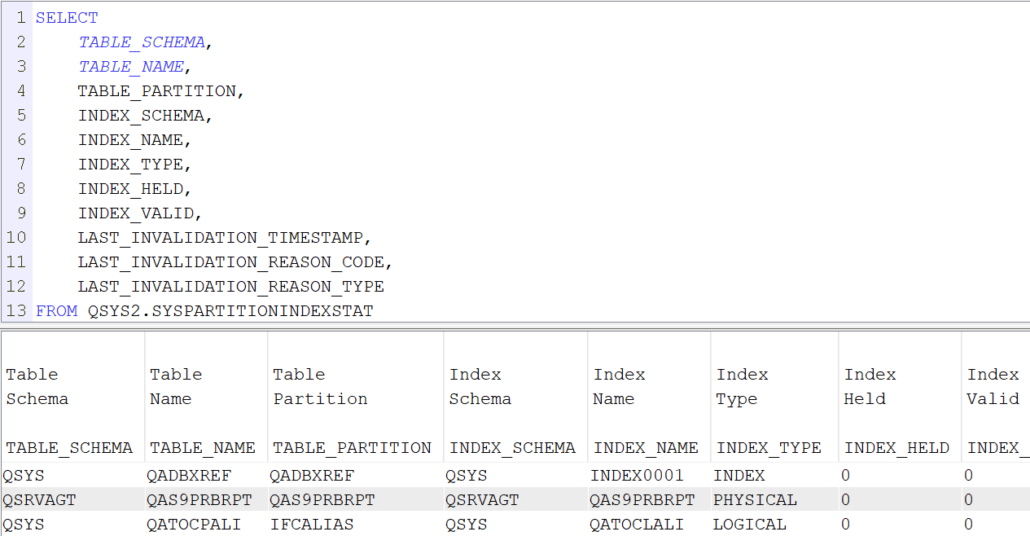
Ci joint la requête pour lister les index invalides sur votre partition
SELECT TABLE_SCHEMA, TABLE_NAME, TABLE_PARTITION, INDEX_SCHEMA, INDEX_NAME, INDEX_TYPE, INDEX_HELD, LAST_INVALIDATION_TIMESTAMP, LAST_INVALIDATION_REASON_CODE, LAST_INVALIDATION_REASON_TYPE FROM QSYS2.SYSPARTITIONINDEXSTAT WHERE INDEX_VALID = ‘0’ ORDER BY LAST_INVALIDATION_TIMESTAMP DESC;
Un index invalide , c’est des index qui nécessitent une intervention pour être utilisable, soit en automatique par exemple à l’ouverture, soit en forçant une action par exemple dans EDTRBDAP
Les valeurs intéressantes qu’on trouvent dans cette analyse
Zone INDEX_VALID
Valeur Signification ‘0’ Index invalide, nécessitant une reconstruction. ‘1’ Index valide. ‘2’ Index sauvegardé avec STG(*FREE) — stockage libéré lors de la sauvegarde.
Zone LAST_INVALIDATION_REASON_CODE Zone LAST_INVALIDATION_REASON_TYPE
Code Type Signification 1 257 Réorganisation. 1 258 Copie. 1 259 Modification par ALTER TABLE ou CHGPF. 1 416 Passage à la maintenance REBLD. 3 773 Chargement partiel. 3 778 ou 779 Index non restauré : sauvegarde potentiellement faite avec ACCPTH(NO), ou index absent lors de la sauvegarde. 4 1089 Invalidation liée à l’IPL ; sous-cause non précisée dans la documentation consultée. 4 1090 Invalidation liée à l’IPL ; sous-cause non précisée dans la documentation consultée. 5 1281 Index désynchronisé du fichier lors d’une récupération de données. 5 1282 Index désynchronisé du fichier lors du contrôle d’une contrainte.
Vous avez également le fichier des indexs à reconstruire
Ci joint la requête, qui liste ces indexs à reconstruire
SELECT * FROM QRECOVERY.QADBERAP;
Status 200 Holder 100 à l’ouverture 001 à 009 priorité
le comptage
SELECT COUNT(*) AS NB_CHEMINS_A_RECONSTRUIRE FROM QRECOVERY.QADBERAP;
le détail
SELECT STATUS, SYSTEM_NAME, FILE_CST_LIB, FILE_MBR, DS_INDEX_LAST_QRY_DATETIME FROM QRECOVERY.QADBERAP;
Correspondance entre QRECOVERY.QADBERAP et QSYS2.SYSPARTITIONINDEXSTAT
Vous retrouverez dans QADBERAP les index de type PHYSICAL présent dans SYSPARTITIONINDEXSTAT zone INDEX_TYPE
;
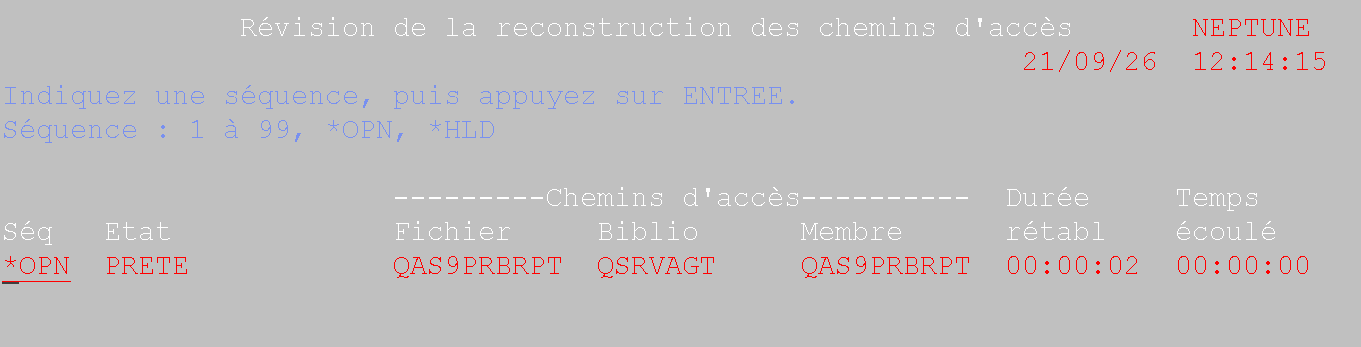
Pour agir vous devez utiliser la commande EDTRBDAP
Vous pourrez indiquer une priorité si vous voulez les reconstruire à la place de *OPN ou *HLD
Conclusions:
Si vous avez des index ce n’est pas forcément grave, exemple si pas de sollicitation depuis 2 ans sur l’index en question. Ce qu’il faut analyser c’est la récurrence, si vous avez des fichiers avec des indexs qui sont souvent en erreur. Il faudra analyser, les objets endommagés , Les logs, etc…
Par exemple, vous utilisez SQL Error Logging Facility (SELF).
Vous voulez analyser les erreurs générées
Les erreurs sont stockées dans la vue SQL_ERROR_LOG de QSYS2
Vous avez une zone LOGGED_SQLCODE et une LOGGED_SQLSTATE qui contiennent le SQLCODE et le SQLSTATE de l’erreur
Vous voulez connaitre l’explication sur l’erreur SQL, vous avez des fonctions table SQLCODE_INFO et SQLCODE_STATE qui interprètent ce code
exemple :
SELECT LOGGED_SQLCODE, STATEMENT_TEXT, STATEMENT_OPERATION_DETAIL, PROGRAM_LIBRARY, PROGRAM_NAME FROM QSYS2.SQL_ERROR;
Ajouter la Fonction table
SELECT LOGGED_SQLCODE, (SELECT Message_text FROM TABLE ( SYSTOOLS.SQLCODE_INFO(LOGGED_SQLCODE) )) AS SQLCODE_TEXT, STATEMENT_TEXT, STATEMENT_OPERATION_DETAIL, PROGRAM_LIBRARY, PROGRAM_NAME FROM QSYS2.SQL_ERROR;
Vous pouvez le faire sur le SQLSTATE ou sur le SQLCODE
Autre exemple, dans une programme RPGLE vous pouvez faire ceci par exemple
W_Text_sql char(512) ; W_sqlcode like(sqlcode) ;
// traitement des erreurs SQL
if sqlcode <> 0; w_sqlcode = sqlcode; exec sql // calcul du nombre de job à supprimer SELECT Message_text into :W_Text_sql FROM TABLE ( SYSTOOLS.SQLCODE_INFO(:w_sqlcode)) ; // Ecriture message dans la log snd-msg (W_Text_sql) ; endif ;
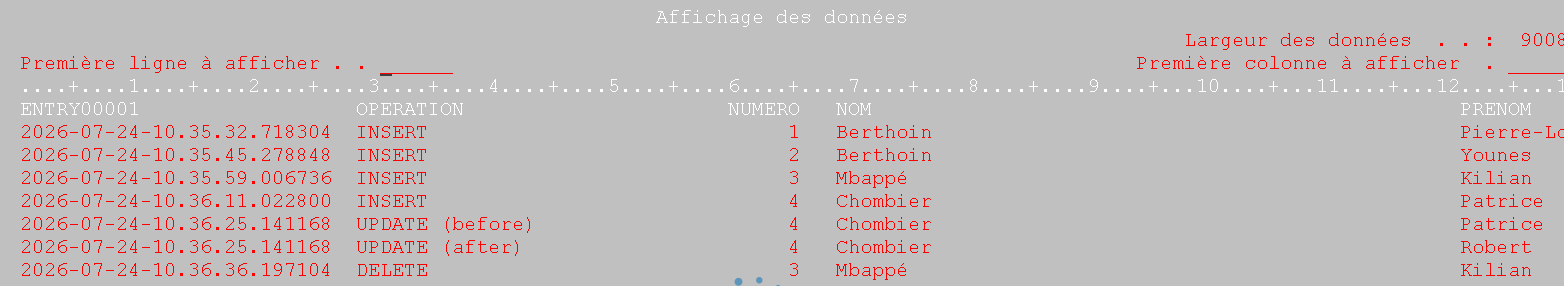
Pour analyser des journaux la difficulté est de traiter le poste *entry data qui est spécifique à chaque fichier
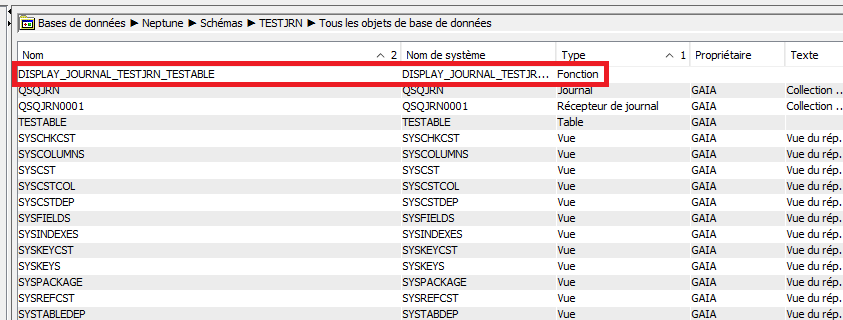
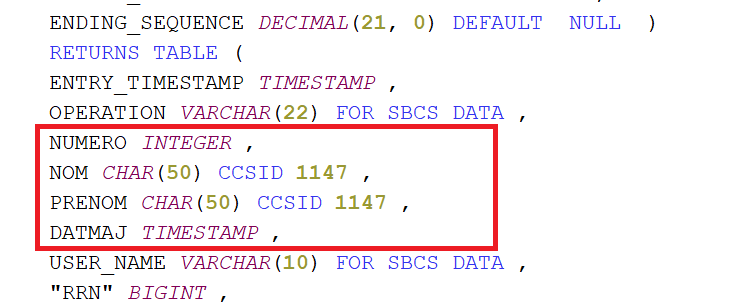
La tr2 de la v7R6 et la tr8 de la v7r5 permet de résoudre cette problématique en créant une fonction spécifique sur un fichier pour analyser les postes de TYPE R
Voici un petit protocole de test
— création d’un schéma
create schema testjrn ;
création d’une table journalisée par défaut sur qdftjrn
CREATE TABLE TESTJRN/TESTABLE ( NUMERO INT NOT NULL WITH DEFAULT, NOM CHAR ( 50) NOT NULL WITH DEFAULT, PRENOM CHAR ( 50) NOT NULL WITH DEFAULT, DATMAJ TIMESTAMP NOT NULL WITH DEFAULT) ;
— génération de modifications dans le journal
INSERT INTO TESTJRN/TESTABLE VALUES(1, ‘Berthoin’, ‘Pierre-Louis’, current timestamp);
INSERT INTO TESTJRN/TESTABLE VALUES(2, ‘Berthoin’, ‘Younes’, current timestamp) ;
INSERT INTO TESTJRN/TESTABLE VALUES(3, ‘Mbappé’, ‘Kilian’, current timestamp) ;
INSERT INTO TESTJRN/TESTABLE VALUES(4, ‘Chombier’, ‘Patrice’, current timestamp) ;
UPDATE TESTJRN/TESTABLE SET PRENOM = ‘Robert’ WHERE NUMERO = 4;
DELETE FROM TESTJRN/TESTABLE WHERE NUMERO =3 :
— génération de la fonction table spécifique à votre fichier
Vous voulez savoir le droit qu’un utilisateur aura quand il tentera d’accéder à un fichier IFS
Voici un script avec les requêtes qui vous aidera à déterminer le droit que vous obtiendrez.
Vous aurez 8 étapes possibles , et il s’arrêtera à la première correspondance.
--
-- Voici une liste de commande SQL pour trouver le droit d'un utilisateur
-- Sur un fichier IFS
-- ici l'utilisateur PLB
-- tente d'accéder au fichier
--/home/plb/Controle_demarrage_SBS.csv
-- 1 si user *ALLOBJ
-- Si oui tous les droits
--
SELECT SPECIAL_AUTHORITIES,
           FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = 'PLB';
--
-- 2 si user sur l'objet
--
SELECT *
    FROM TABLE (
            QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
        )
    WHERE AUTHORIZATION_NAME = 'PLB';
--
-- 3 si utilisateur dans liste d'autorisations
--
SELECT *
    FROM QSYS2.AUTHORIZATION_LIST_USER_INFO
    WHERE AUTHORIZATION_NAME = 'PLB'
          AND AUTHORIZATION_LISt = (SELECT AUTHORIZATION_LIST
                  FROM TABLE (
                          QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
                      )
                  WHERE AUTHORIZATION_NAME <> '*PUBLIC');
--
-- 4 si groupe all obj
-- Si oui tous les droits
--
  SELECT
       SPECIAL_AUTHORITIES
           FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = ( SELECT GROUP_PROFILE_NAME
    FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = 'PLB');
--
-- 5 si groupe sur l'objet
--
  SELECT * FROM  TABLE(QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv'))
  where AUTHORIZATION_NAME =
    ( SELECT GROUP_PROFILE_NAME
    FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = 'PLB');
--
--6 Si groupe dans la liste d'autorisation
--
SELECT *
    FROM QSYS2.AUTHORIZATION_LIST_USER_INFO
    WHERE AUTHORIZATION_NAME = (SELECT GROUP_PROFILE_NAME
                  FROM qsys2.user_info
                  WHERE AUTHORIZATION_NAME = 'PLB')
          AND AUTHORIZATION_LIST = (SELECT AUTHORIZATION_LIST
                  FROM TABLE (
                          QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
                      )
                  WHERE AUTHORIZATION_NAME <> '*PUBLIC');
--
--7 Si public
--
SELECT *
    FROM TABLE (
            QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
        )
    WHERE AUTHORIZATION_NAME = '*PUBLIC'
          AND DATA_AUTHORITY <> '*AUTL';
--
--8 Si public reporté sur la liste d'autorisation
--
SELECT *
    FROM QSYS2.AUTHORIZATION_LIST_USER_INFO
    WHERE AUTHORIZATION_NAME = '*PUBLIC'
          AND AUTHORIZATION_LISt = (SELECT AUTHORIZATION_LIST
                  FROM TABLE (
                         QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
                      )
                  WHERE AUTHORIZATION_NAME <> '*PUBLIC');
Remarque :
Ce mécanisme peut être complété par des groupe additionnels , les droits proposés devenant complétifs (‘Ajouter au droit existant’)
Il est conseillé de les utiliser modérément , on peut avoir un système de droit assez efficace juste avec le mécanisme historique
Dans l’IFS l’adoption de droit ne s’applique pas, mais dans vos sript sh vous pouvez utiliser la notion de SETUID
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2026-07-03 10:13:032026-07-03 10:13:04Droit d’utilisateur sur un fichier IFS
Pour connaitre le type d’un fichier, vous pouvez vous baser sur le type du Fichier .PDF, .JPG, etc …
Ou vous baser sur le nombre magique , ou signature binaire soit les 4 premiers octets en Hexa
SELECT HEX(SUBSTR(LINE, 1, 4)) AS SIGNATURE FROM TABLE(QSYS2.IFS_READ_BINARY(‘/home/test.pdf’)) FETCH FIRST 1 ROW ONLY;
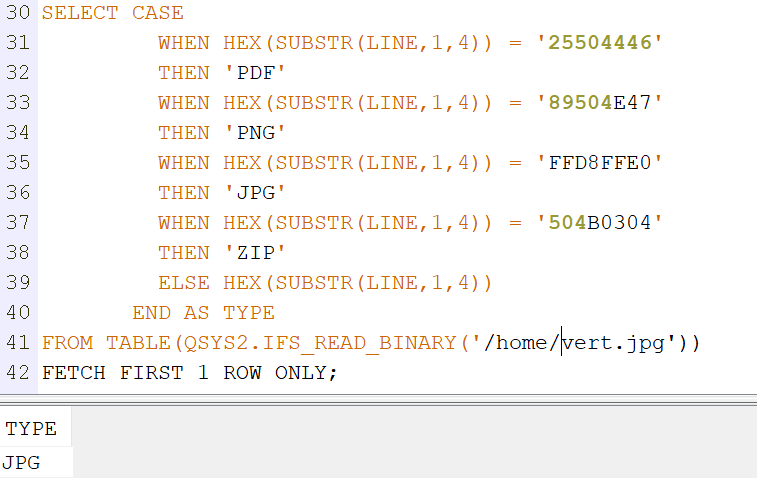
Voici un exemple sur 4 fichiers que vous pouvez trouver sur votre partition
SELECT CASE
         WHEN HEX(SUBSTR(LINE,1,4)) = '25504446'
         THEN 'PDF'
         WHEN HEX(SUBSTR(LINE,1,4)) = '89504E47'
         THEN 'PNG'
         WHEN HEX(SUBSTR(LINE,1,4)) = 'FFD8FFE0'
         THEN 'JPG'
         WHEN HEX(SUBSTR(LINE,1,4)) = '504B0304'
         THEN 'ZIP'
         ELSE 'Autre' // inconnu
       END AS TYPE
FROM TABLE(QSYS2.IFS_READ_BINARY('/home/vert.jpg'))
FETCH FIRST 1 ROW ONLY;
Résultat :
Conclusion :
C’est simple, et efficace, il y a sans doute d’autres manières de faire
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2026-05-11 14:42:272026-05-11 14:42:28Trouver le type d’un fichier
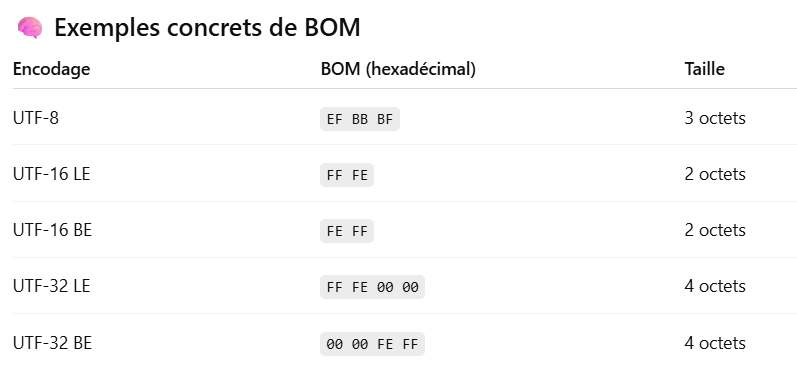
BOM signifie Byte Order Mark 👉 en français : marque d’ordre des octets
C’est une séquence d’octets placée au tout début d’un fichier texte pour indiquer :
l’encodage du fichier
parfois l’ordre des octets (endianness)
📌 À quoi sert un BOM ? 1️⃣ Identifier l’encodage
Quand un logiciel ouvre un fichier, le BOM lui dit :
« Ce fichier est en UTF-8 / UTF-16 / UTF-32 »
Sans BOM, certains outils devinent l’encodage… et se trompent.
2️⃣ Indiquer l’ordre des octets (UTF-16 / UTF-32)
Pour les encodages multi-octets :
Little Endian
Big Endian
Le BOM permet de savoir dans quel ordre lire les octets.
Sur L’IBMi on l’utilisera pour échanger un fichier UTF8 avec un autre système que le réclame, ou à l’inverse il faudra l’enlever sur un fichier recu !
Voici 2 procédures pour vous aider et une requête
Une requête pour afficher le BOM sur un fichier IFS
WITH FICHIER AS (
    SELECT DATA
    FROM TABLE (
        QSYS2.IFS_READ_BINARY('/tmp/test.txt')
    )
)
SELECT
    HEX(SUBSTR(DATA, 1, 4))      AS BOM_HEXA,
    CASE
        WHEN SUBSTR(DATA, 1, 3) = X'EFBBBF'
            THEN 'UTF-8 avec BOM'
        WHEN SUBSTR(DATA, 1, 2) = X'FFFE'
            THEN 'UTF-16 Little Endian'
        WHEN SUBSTR(DATA, 1, 2) = X'FEFF'
            THEN 'UTF-16 Big Endian'
        WHEN SUBSTR(DATA, 1, 4) = X'FFFE0000'
            THEN 'UTF-32 Little Endian'
        WHEN SUBSTR(DATA, 1, 4) = X'0000FEFF'
            THEN 'UTF-32 Big Endian'
        ELSE
            'Aucun BOM détecté (UTF-8 sans BOM probable)'
    END AS ENCODAGE_DETECTE
FROM FICHIER;
Une procédure pour ajouter un BOM sur un fichier à envoyer
CREATE OR REPLACE PROCEDURE AJOUTER_BOM (
IN p_path VARCHAR(1024) CCSID 1208,
IN p_bom VARCHAR(10)
)
LANGUAGE SQL
BEGIN
DECLARE v_data BLOB(10M);
DECLARE v_new_data BLOB(10M);
DECLARE v_bom BLOB(4);-- Déterminer le BOM à ajouter
SET v_bom =
    CASE UPPER(p_bom)
        WHEN 'UTF8'     THEN X'EFBBBF'
        WHEN 'UTF16LE'  THEN X'FFFE'
        WHEN 'UTF16BE'  THEN X'FEFF'
        ELSE NULL
    END;

IF v_bom IS NULL THEN
    SIGNAL SQLSTATE '38001'
        SET MESSAGE_TEXT = 'BOM non reconnu (UTF8, UTF16LE, UTF16BE)';
END IF;

-- Lire le fichier
SELECT DATA
  INTO v_data
  FROM TABLE (
    QSYS2.IFS_READ_BINARY(p_path)
  );

-- Vérifier si le BOM est déjà présent
IF SUBSTR(v_data, 1, LENGTH(v_bom)) <> v_bom THEN
    SET v_new_data = v_bom || v_data;

    -- Réécriture du fichier avec BOM
    CALL QSYS2.IFS_WRITE_BINARY(
        PATH_NAME => p_path,
        DATA      => v_new_data,
        REPLACE   => 1
    );
END IF;
END;
Une procédure pour enlever le BOM
CREATE OR REPLACE PROCEDURE SUPPRIMER_BOM (
IN p_path VARCHAR(1024) CCSID 1208,
IN p_bom VARCHAR(10)
)
LANGUAGE SQL
BEGIN
DECLARE v_data BLOB(10M);
DECLARE v_bom BLOB(4);
DECLARE v_len INTEGER;-- Déterminer le BOM à supprimer
SET v_bom =
    CASE UPPER(p_bom)
        WHEN 'UTF8'     THEN X'EFBBBF'
        WHEN 'UTF16LE'  THEN X'FFFE'
        WHEN 'UTF16BE'  THEN X'FEFF'
        WHEN 'UTF32LE'  THEN X'FFFE0000'
        WHEN 'UTF32BE'  THEN X'0000FEFF'
        ELSE NULL
    END;

IF v_bom IS NULL THEN
    SIGNAL SQLSTATE '38001'
        SET MESSAGE_TEXT =
          'BOM non reconnu (UTF8, UTF16LE, UTF16BE, UTF32LE, UTF32BE)';
END IF;

SET v_len = LENGTH(v_bom);

-- Lire le fichier
SELECT DATA
  INTO v_data
  FROM TABLE (
    QSYS2.IFS_READ_BINARY(p_path)
  );

-- Vérifier et supprimer le BOM demandé
IF SUBSTR(v_data, 1, v_len) = v_bom THEN
    SET v_data = SUBSTR(v_data, v_len + 1);

    -- Réécrire le fichier sans BOM
    CALL QSYS2.IFS_WRITE_BINARY(
        PATH_NAME => p_path,
        DATA      => v_data,
        REPLACE   => 1
    );
END IF;
END;
Conclusion
Sur IBMi ca ne sert à rien le CCSID donne cette information
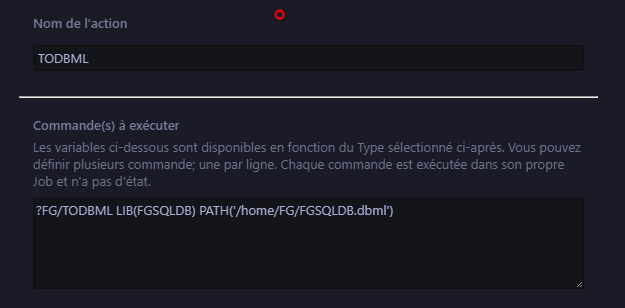
Ajouter l’action dans VSCode en remplaçant <BIBOBJ>, <BIBBDD>, <PATH> par votre bibliothèque, la bibliothèque de base de données et le chemin du fichier à générer :
?<BIBOBJ>/TODBML LIB(<BIBBDD>) PATH('<PATH>')
Paramètres de la commande:
LIB : Bibliothèque de la base de données
PATH : Le chemin du fichier dbml qui sera généré
Exemple :
ps : Vous pouvez faire une action de type « fichier » avec rafraichissement de filtre.
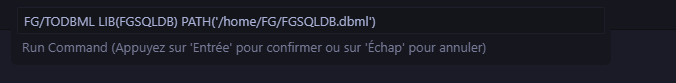
Lancer l’action
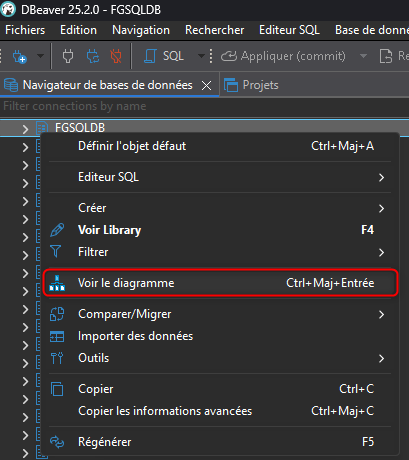
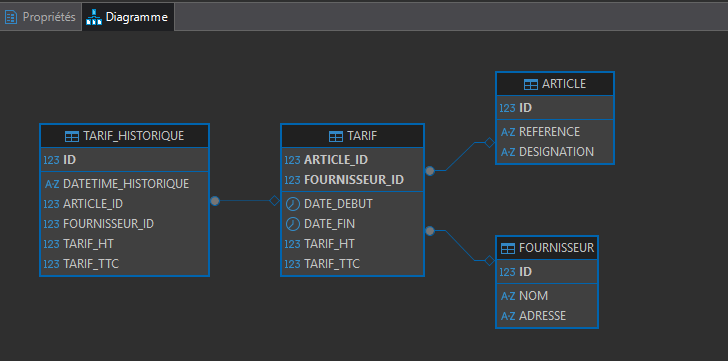
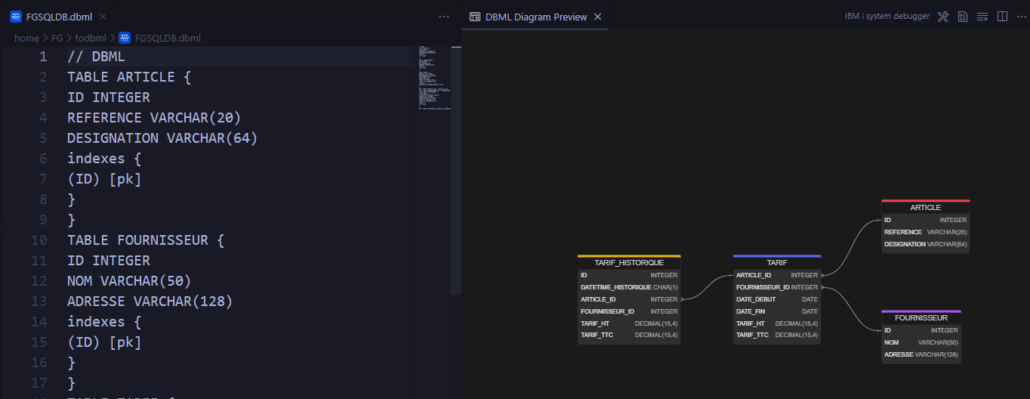
Visualisation du diagramme
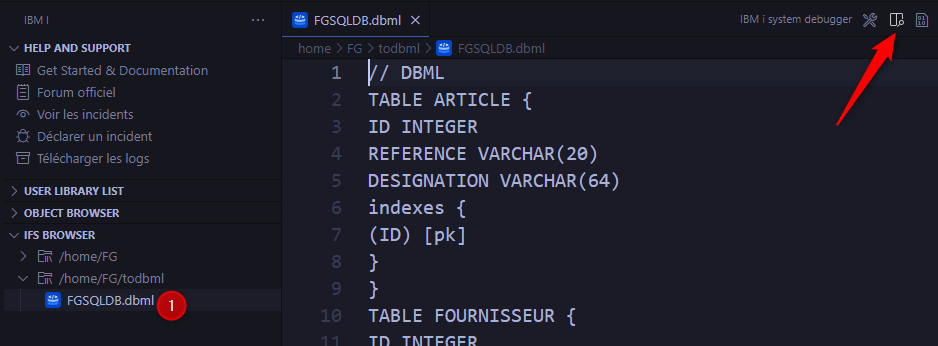
Ouvrir le fichier et cliquer sur l’icone « show diagram » en haut à droite.
A vous de jouer !
Il est intéressant de constater que la richesse du rendu semble proportionnelle à la densité des relations dans la base… une coïncidence, sans doute 🙂
/wp-content/uploads/2017/05/logogaia.png00Florian Gradot/wp-content/uploads/2017/05/logogaia.pngFlorian Gradot2025-09-18 09:35:242025-09-29 10:22:24Schéma de base données dans VSCode
Suite à des demandes multiples, je propose une implémentation de « DUMP » des enregistrements d’une table (plutôt d’un objet *FILE / PF-DTA, que ce soit un PF ou une table).
L’idée est d’obtenir u script SQL contenant les instructions INSERT permettant de reproduire les données dans une autre base.
Premièrement, la réplication de données sans utiliser les commandes de sauvegarde/restauration. Ces dernières nécessitent des droits élevés, alors qu’ici nous ne faisons que manipuler de la donnée.
Deuxièmement, dans le cadre de traitement de journaux (initialement en vue d’une fonction de type CDC), pour permettre d’isoler un enregistrement que l’on souhaite répliquer (avec ou sans transformation) dans une autre table.
Vous trouverez certainement d’autres usages !
Limites
Le code est fourni « as is », pour démonstration.
Quelques limites d’usage actuellement
Types de colonnes non supportées actuellement : CLOB, BLOB, DATALINK, XML, GRAPHIC, VARGRAPHIC, {VAR}CHAR CCSID 65535
Pas plus de 16Mo par enregistrement
On ne gère pas les alias, partitions, IASP
250 colonnes maximum
En cas de multi-membres, seul le premier membre est traité
On peut bien évidemment ajouter de nouvelles fonctionnalités !
N’hésitez pas à donner un feedback, améliorer le code