Les Index INVALIDES
L’Analyse des indexs consiste souvent à analyser
-Les indexs qui manquent, ou les MTI crées
-Les indexs inutilisés
Mais il faut aussi analyser
-Les indexs Invalides
-Les indexs à reconstruire
Ci joint la requête pour lister les index invalides sur votre partition
SELECT
TABLE_SCHEMA,
TABLE_NAME,
TABLE_PARTITION,
INDEX_SCHEMA,
INDEX_NAME,
INDEX_TYPE,
INDEX_HELD,
LAST_INVALIDATION_TIMESTAMP,
LAST_INVALIDATION_REASON_CODE,
LAST_INVALIDATION_REASON_TYPE
FROM QSYS2.SYSPARTITIONINDEXSTAT
WHERE INDEX_VALID = ‘0’
ORDER BY LAST_INVALIDATION_TIMESTAMP DESC;
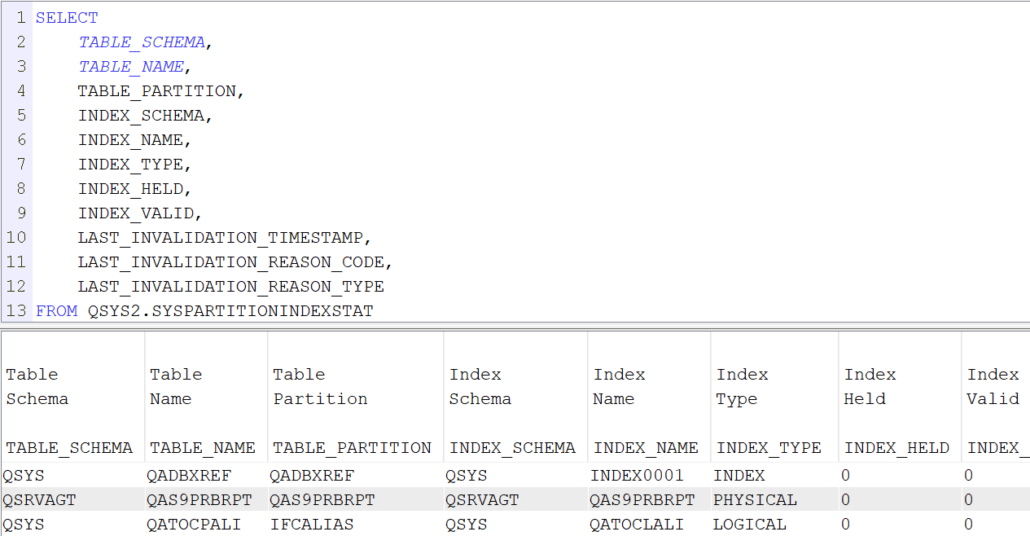
Un index invalide , c’est des index qui nécessitent une intervention pour être utilisable, soit en automatique par exemple à l’ouverture, soit en forçant une action par exemple dans EDTRBDAP
Les valeurs intéressantes qu’on trouvent dans cette analyse
Zone INDEX_VALID
Valeur Signification
‘0’ Index invalide, nécessitant une reconstruction.
‘1’ Index valide.
‘2’ Index sauvegardé avec STG(*FREE) — stockage libéré lors de la sauvegarde.
Zone LAST_INVALIDATION_REASON_CODE
Zone LAST_INVALIDATION_REASON_TYPE
Code Type Signification
1 257 Réorganisation.
1 258 Copie.
1 259 Modification par ALTER TABLE ou CHGPF.
1 416 Passage à la maintenance REBLD.
3 773 Chargement partiel.
3 778 ou 779 Index non restauré : sauvegarde potentiellement faite avec ACCPTH(NO), ou index absent lors de la sauvegarde.
4 1089 Invalidation liée à l’IPL ; sous-cause non précisée dans la documentation consultée.
4 1090 Invalidation liée à l’IPL ; sous-cause non précisée dans la documentation consultée.
5 1281 Index désynchronisé du fichier lors d’une récupération de données.
5 1282 Index désynchronisé du fichier lors du contrôle d’une contrainte.
Vous avez également le fichier des indexs à reconstruire
Ci joint la requête, qui liste ces indexs à reconstruire
SELECT *
FROM QRECOVERY.QADBERAP;
Status
200 Holder
100 à l’ouverture
001 à 009 priorité
le comptage
SELECT COUNT(*) AS NB_CHEMINS_A_RECONSTRUIRE
FROM QRECOVERY.QADBERAP;
le détail
SELECT STATUS,
SYSTEM_NAME,
FILE_CST_LIB,
FILE_MBR,
DS_INDEX_LAST_QRY_DATETIME
FROM QRECOVERY.QADBERAP;
Correspondance entre QRECOVERY.QADBERAP et QSYS2.SYSPARTITIONINDEXSTAT
Vous retrouverez dans QADBERAP les index de type PHYSICAL présent dans SYSPARTITIONINDEXSTAT zone INDEX_TYPE
;
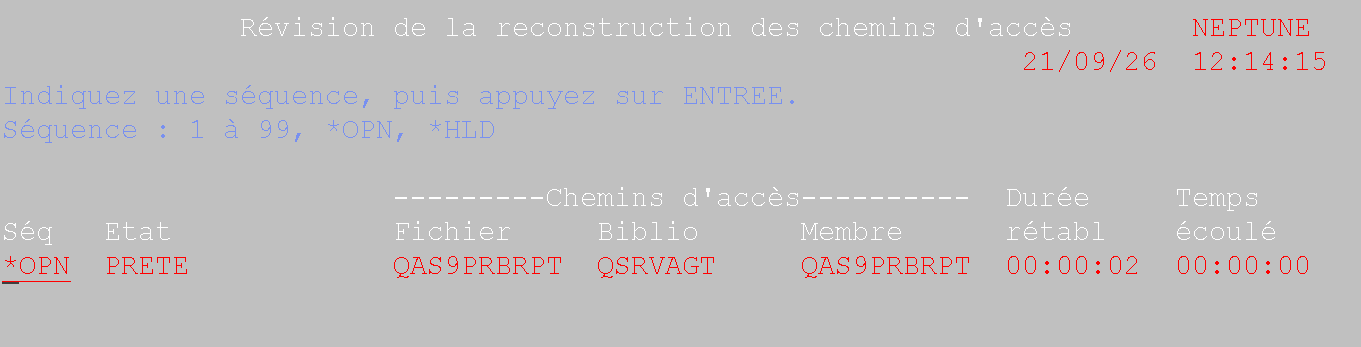
Pour agir vous devez utiliser la commande EDTRBDAP
Vous pourrez indiquer une priorité si vous voulez les reconstruire à la place de *OPN ou *HLD
Conclusions:
Si vous avez des index ce n’est pas forcément grave, exemple si pas de sollicitation depuis 2 ans sur l’index en question.
Ce qu’il faut analyser c’est la récurrence, si vous avez des fichiers avec des indexs qui sont souvent en erreur.
Il faudra analyser, les objets endommagés , Les logs, etc…
Récupérer le SQL d’un QRY avec RTVQMQRY
Vous avez un ancien objet *QRY sur votre IBM i et vous souhaitez retrouver la requête SQL correspondante ?
La commande RTVQMQRY permet de récupérer la requête d’un objet Query et de la restituer sous forme de source SQL.
Petit exemple :
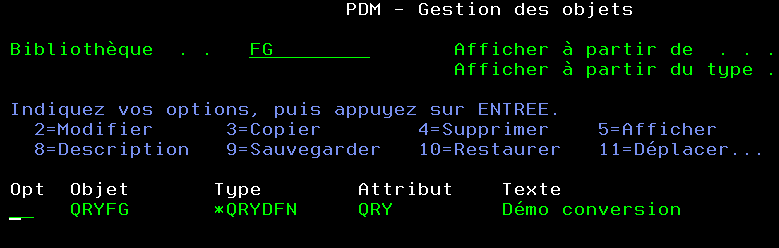
Lancement de la commande de récupération
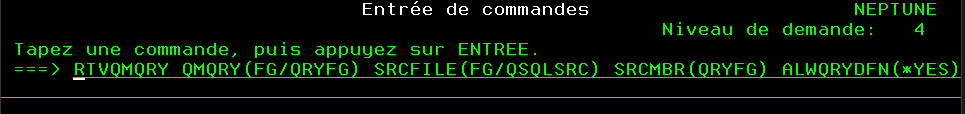
Résultat :
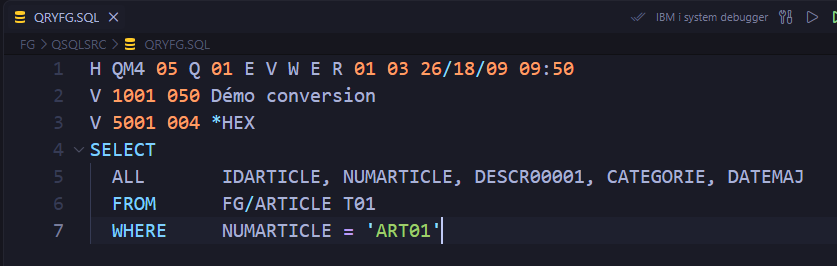
Commande :
RTVQMQRY QMQRY(FG/QRYFG) SRCFILE(FG/QSQLSRC) SRCMBR(QRYFG) ALWQRYDFN(*YES)Le résultat peut ensuite être consulté ou retravaillé comme du SQL.
C’est particulièrement utile lorsqu’on intervient sur un ancien patrimoine IBM i et que l’on souhaite :
- comprendre une requête existante ;
- retrouver sa logique SQL ;
- documenter un traitement ;
- préparer sa migration vers SQL.
Une commande IBM i assez méconnue, mais très pratique lorsqu’on doit faire parler un ancien objet Query.
Répondre à un message en SQL
Vous voulez répondre à un message dans la file d’attente QSYSOPR dans un de vos développements.
Vous devez utiliser la commande SNDRPY,
vous pouvez lui indiquer la réponse souhaitée, mais vous devez connaître la clé du message.
Cette clé est unique sur 4 caractères c’est le système qui la génère à l’envoi
Vous aurez donc souvent dans votre clp
DCL &key *char 4
RCVMSG … MSGKEY(&key)
SNDRPY …MSGKEY(&key)
Mais comment faire en SQL
Vous avez une vue qui vous permet de lire les messages d’une file (QSYS2.MESSAGE_QUEUE_INFO) et donc de récupérer la clé nécessaire.
Exemple
-- message avec réponse
  SELECT  MESSAGE_KEY
    FROM QSYS2.MESSAGE_QUEUE_INFO
    WHERE MESSAGE_QUEUE_NAME = 'QSYSOPR'
          AND MESSAGE_TYPE = 'INQUIRY';
-- message avec réponse pas encore répondu
WITH REPLIED_MSGS (KEY) AS (
SELECT A.MESSAGE_KEY
FROM QSYS2.MESSAGE_QUEUE_INFO A
INNER JOIN QSYS2.MESSAGE_QUEUE_INFO B
ON A.MESSAGE_KEY = B.ASSOCIATED_MESSAGE_KEY
WHERE A.MESSAGE_QUEUE_NAME = 'QSYSOPR'
AND A.MESSAGE_QUEUE_LIBRARY = 'QSYS'
AND B.MESSAGE_QUEUE_NAME = 'QSYSOPR'
AND B.MESSAGE_QUEUE_LIBRARY = 'QSYS'
ORDER BY B.MESSAGE_TIMESTAMP DESC)
SELECT HEX(A.MESSAGE_KEY) AS MSGKEY
FROM QSYS2.MESSAGE_QUEUE_INFO A
LEFT EXCEPTION JOIN REPLIED_MSGS B
ON A.MESSAGE_KEY = B.KEY
WHERE MESSAGE_QUEUE_NAME = 'QSYSOPR'
AND MESSAGE_QUEUE_LIBRARY = 'QSYS'
AND MESSAGE_TYPE = 'INQUIRY'
ORDER BY MESSAGE_TIMESTAMP DESC;Vous pourrez alors utiliser la fonction QCMDEXC pour lancer un SNDRPY paramétré
-- Avec Réponse au message
WITH REPLIED_MSGS (KEY) AS (
        SELECT A.MESSAGE_KEY
            FROM QSYS2.MESSAGE_QUEUE_INFO A
                 INNER JOIN QSYS2.MESSAGE_QUEUE_INFO B
                     ON A.MESSAGE_KEY = B.ASSOCIATED_MESSAGE_KEY
            WHERE A.MESSAGE_QUEUE_NAME = 'QSYSOPR'
                  AND A.MESSAGE_QUEUE_LIBRARY = 'QSYS'
                  AND B.MESSAGE_QUEUE_NAME = 'QSYSOPR'
                  AND B.MESSAGE_QUEUE_LIBRARY = 'QSYS'
            ORDER BY B.MESSAGE_TIMESTAMP DESC)
    SELECT QCMDEXC(
            'QSYS/SNDRPY MSGKEY(X''' CONCAT HEX(MESSAGE_KEY) CONCAT ''') MSGQ('
            CONCAT MESSAGE_QUEUE_LIBRARY CONCAT '/'
            CONCAT MESSAGE_QUEUE_NAME CONCAT ') RPY(''C'') RMV(*NO)')
        FROM QSYS2.MESSAGE_QUEUE_INFO A
             LEFT EXCEPTION JOIN REPLIED_MSGS B
                 ON A.MESSAGE_KEY = B.KEY
        WHERE MESSAGE_QUEUE_NAME = 'QSYSOPR'
              AND MESSAGE_QUEUE_LIBRARY = 'QSYS'
              AND MESSAGE_TYPE = 'INQUIRY'
        ORDER BY MESSAGE_TIMESTAMP DESC;
On a choisit de répondre C et de ne pas enlever le message dans la file
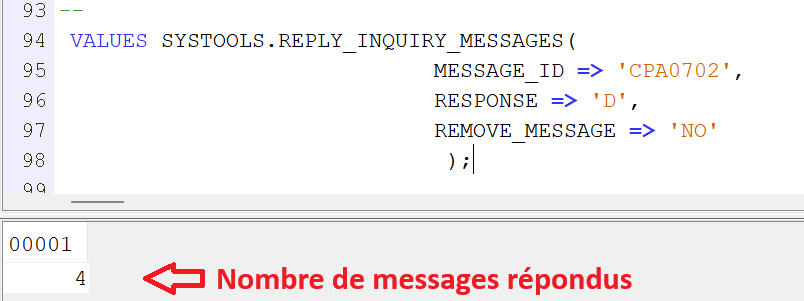
Mais les équipes de Scott on eu pitié de vous et dans SYSTOOLS vous avez la fonction REPLY_INQUIRY_MESSAGES
Voici comment elle s’utilise :
-- réponse sur un message sans MSGID par exemple envoyé par un SNDMSG ou SNDUSRMSG
    -- le texte est obligatoire pour filtrer
         VALUES SYSTOOLS.REPLY_INQUIRY_MESSAGES(
                             MESSAGE_ID => '*IMMED',
                             SEARCH_MESSAGE_TEXT => 'TESTPLB',
                             RESPONSE => 'C',
                             REMOVE_MESSAGE => 'NO'
                              );
   -- réponse sur un message MSGID  c'est toujours CPA0702
   -- vous devez indiquer ensuite votre MSGID
                              VALUES SYSTOOLS.REPLY_INQUIRY_MESSAGES(
                             MESSAGE_ID => 'CPA0702', -- toujours ce message pour l'envoi
                             SEARCH_MESSAGE_TEXT => 'CPF0001', -- message applicatif
                             RESPONSE => 'C',
                             REMOVE_MESSAGE => 'NO'
                             );
  -- réponse sur un texte de message ici erreur PGM
  -- vous devez indiquer ensuite votre TEXT
                         VALUES SYSTOOLS.REPLY_INQUIRY_MESSAGES(
                             MESSAGE_ID => 'CPA0702',
                             SEARCH_MESSAGE_TEXT => 'ERREURPGM', -- filtré
                             RESPONSE => 'C',
                             REMOVE_MESSAGE => 'NO'
                             );
Remarque :
Vous pouvez extraire le source de la fonction de SYSTOOLS pour la personnaliser, ailleurs de préférence
Rappel :
Ce n’est pas parce que c’est possible qu’il faut le faire, des fois ne pas répondre peut être le bon réflexe.
Pour ne savoir plus :
Fonctions et procédures SQL Surchargées
Vous pouvez utiliser la notion de surchargées SQL
Une surcharge c’est le fait de pouvoir appeler avec plusieurs prototypages différents, une fonction ou une procédure SQL
Voici un exemple :
soit une fonction qui convertit un integer en char

CREATE OR REPLACE FUNCTION PLB.FORMAT_CODE(P_VAL INTEGER)
RETURNS VARCHAR(10)
LANGUAGE SQL
SPECIFIC FORMAT_CODE_INT
BEGIN
    RETURN CHAR(P_VAL);
END;
soit une fonction même nom qui convertit un char en majuscule
CREATE OR REPLACE FUNCTION PLB.FORMAT_CODE(P_VAL VARCHAR(10))
RETURNS VARCHAR(10)
LANGUAGE SQL
SPECIFIC FORMAT_CODE_CHAR
BEGIN
    RETURN UPPER(TRIM(P_VAL));
END;
— Voici un jeu d’essai pour tester ces fonctions
— Création table de test
CREATE TABLE PLB.TESTSUR (
TESTINT INT NOT NULL WITH DEFAULT,
TESTCHAR VARCHAR ( 10) NOT NULL WITH DEFAULT)
INSERT INTO PLB.TESTSUR VALUES(1964, ‘PIERRE’) ;
INSERT INTO PLB.TESTSUR VALUES(1987, ‘Robert’) ;
— Test
SELECT plb.FORMAT_CODE(TESTINT),
plb.FORMAT_CODE(TESTCHAR)
FROM PLB.TESTSUR;
SQL choisit la fonction en fonction du type de paramètres reçus
Remarque :
il peut être intéressant de savoir si on a des fonctions ou procédures surchargées sur notre partition, notamment en cas de maintenance, cette information est importante.
Voici une petite requête pour analyser tout ca
SELECT   ROUTINE_SCHEMA,
         ROUTINE_NAME,
         COUNT(*)    AS NB_VARIANTES,
         'FONCTION'  AS TYPE_ROUTINE
FROM     QSYS2.SYSFUNCS
WHERE ROUTINE_SCHEMA not LIKE('SYS%')
and ROUTINE_SCHEMA not LIKE('QSYS%')
GROUP BY ROUTINE_SCHEMA,
         ROUTINE_NAME
HAVING   COUNT(*) > 1
UNION
SELECT   ROUTINE_SCHEMA,
         ROUTINE_NAME,
         COUNT(*)    AS NB_VARIANTES,
         'PROCEDURE' AS TYPE_ROUTINE
FROM     QSYS2.SYSPROCS
WHERE ROUTINE_SCHEMA not LIKE('SYS%')
and ROUTINE_SCHEMA not LIKE('QSYS%')
GROUP BY ROUTINE_SCHEMA,
         ROUTINE_NAME
HAVING   COUNT(*) > 1
ORDER BY ROUTINE_SCHEMA,
         ROUTINE_NAME,
         TYPE_ROUTINE;
Vous pouvez facilement l’améliorer en joignant avec la vue SYSPARMS par exemple
Interprétation SQLCODE et SQLSTATE
Par exemple, vous utilisez SQL Error Logging Facility (SELF).
Vous voulez analyser les erreurs générées
Les erreurs sont stockées dans la vue SQL_ERROR_LOG de QSYS2
Vous avez une zone LOGGED_SQLCODE et une LOGGED_SQLSTATE qui contiennent le SQLCODE et le SQLSTATE de l’erreur
Vous voulez connaitre l’explication sur l’erreur SQL, vous avez des fonctions table SQLCODE_INFO et SQLCODE_STATE qui interprètent ce code
exemple :
SELECT LOGGED_SQLCODE,
STATEMENT_TEXT,
STATEMENT_OPERATION_DETAIL,
PROGRAM_LIBRARY,
PROGRAM_NAME
FROM QSYS2.SQL_ERROR;
Ajouter la Fonction table
SELECT LOGGED_SQLCODE,
(SELECT Message_text
FROM TABLE (
SYSTOOLS.SQLCODE_INFO(LOGGED_SQLCODE)
)) AS SQLCODE_TEXT,
STATEMENT_TEXT,
STATEMENT_OPERATION_DETAIL,
PROGRAM_LIBRARY,
PROGRAM_NAME
FROM QSYS2.SQL_ERROR;
Vous pouvez le faire sur le SQLSTATE ou sur le SQLCODE
Autre exemple, dans une programme RPGLE vous pouvez faire ceci par exemple
W_Text_sql char(512) ;
W_sqlcode like(sqlcode) ;
// traitement des erreurs SQL
if sqlcode <> 0;
w_sqlcode = sqlcode;
exec sql
// calcul du nombre de job à supprimer
SELECT Message_text into :W_Text_sql
FROM TABLE (
SYSTOOLS.SQLCODE_INFO(:w_sqlcode))
;
// Ecriture message dans la log
snd-msg (W_Text_sql) ;
endif ;
Plus d’informations ici
https://www.ibm.com/docs/en/i/7.6.0?topic=services-sqlcode-info-table-function
https://www.ibm.com/docs/en/i/7.6.0?topic=services-sqlstate-info-table
Rappel
il est important de traiter les erreurs SQL sur chaque instruction
Fonction QCMDEXC dans un programme SQLRPGLE
Par exemple, vous voulez créer une commande qui suppriment les travaux d’un utilisateur avec des noms dupliqués ce que ne permet pas la Commande ENDJOB nativement.
Vous choisissez de le faire en SQLRPGLE, vous avez la fonction table QSYS2.ACTIVE_JOB_INFO qui va permettre de trouver les travaux à supprimer
Exemple :
Pour savoir le nombre de travaux à supprimer
dcl-s w_cnt int(10);
P_jobn = ‘QHSTB’ ;
P_user = ‘PLB’;
exec sql
SELECT COUNT(*)
INTO :w_cnt
FROM TABLE (
QSYS2.ACTIVE_JOB_INFO(JOB_NAME_FILTER => :p_jobnm)
) A
WHERE A.JOB_USER = :p_user ;
Remarque
Vous pouvez indiquer le nom du job dans le filtre et l’utilisateur dans la clause where de sélection
Maintenant pour agir vous devez utiliser la fonction QCMDEXC
SELECT QCMDEXC(‘ENDJOB JOB(‘ concat trim(A.JOB_NAME) concat ‘) OPTION(*IMMED)’)
FROM TABLE (
QSYS2.ACTIVE_JOB_INFO(JOB_NAME_FILTER => :P_jobn)
) A
WHERE A.JOB_USER = :p_user ;
Cette commande marche dans ACS par exemple, ou ajoutant un create table as dans un RUNSQL ou un RUNSQLSTM;
Le probléme de cette solution en RPGLE est qu’elle va vous obliger à avoir un curseur
soit dans le RPGLE
soit en faisant du Dynamic Compound Statement (Compile de code SQL à la volée)
Voici une astuce qui va permettre d’éviter le curseur
exec sql
SELECT COUNT(*) INTO :w_cnt
FROM TABLE(QSYS2.ACTIVE_JOB_INFO(
JOB_NAME_FILTER => :p_jobnm)) AS A
WHERE A.JOB_USER = :p_user
AND QSYS2.QCMDEXC(
‘ENDJOB JOB(‘ CONCAT TRIM(A.JOB_NAME)
CONCAT ‘) OPTION(*IMMED)’
) = 1;
On va utiliser le QCMDEXC dans la clause where
En effet cette fonction renvoie 1 quand c’est ok
Conclusions :
C’est simple et efficace
Mais attention à la sécurité et l’injection de code par exemple avec une clause where paramétrable qui peut permettre de passer n’importe quelle commande ?
Astuce :
Vous pouvez faire une commande qui lancera votre programme
CMD PROMPT(‘Arrêter plusieurs Travaux’)
PARM KWD(JOBNM) TYPE(*NAME) LEN(10) MIN(1) +
PROMPT(‘Travail’)
PARM KWD(USER) TYPE(*NAME) LEN(10) MIN(1) +
PROMPT(‘Utilisateur’)
Fonction CREATE_DATA_JOURNAL_READER
Fonction QSYS2.CREATE_DATA_JOURNAL_READER
Pour analyser des journaux la difficulté est de traiter le poste *entry data qui est spécifique à chaque fichier
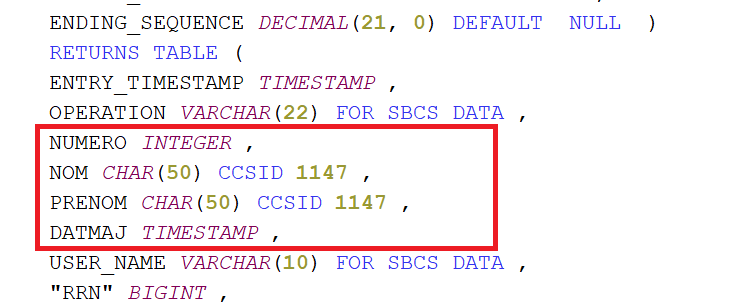
La tr2 de la v7R6 et la tr8 de la v7r5 permet de résoudre cette problématique en créant une fonction spécifique sur un fichier pour analyser les postes de TYPE R
Voici un petit protocole de test
— création d’un schéma
create schema testjrn ;
- création d’une table journalisée par défaut sur qdftjrn
CREATE TABLE TESTJRN/TESTABLE (
NUMERO INT NOT NULL WITH DEFAULT,
NOM CHAR ( 50) NOT NULL WITH DEFAULT,
PRENOM CHAR ( 50) NOT NULL WITH DEFAULT,
DATMAJ TIMESTAMP NOT NULL WITH DEFAULT) ;
— génération de modifications dans le journal
INSERT INTO TESTJRN/TESTABLE VALUES(1, ‘Berthoin’, ‘Pierre-Louis’,
current timestamp);
INSERT INTO TESTJRN/TESTABLE VALUES(2, ‘Berthoin’, ‘Younes’,
current timestamp) ;
INSERT INTO TESTJRN/TESTABLE VALUES(3, ‘Mbappé’, ‘Kilian’, current
timestamp) ;
INSERT INTO TESTJRN/TESTABLE VALUES(4, ‘Chombier’, ‘Patrice’,
current timestamp) ;
UPDATE TESTJRN/TESTABLE SET PRENOM = ‘Robert’ WHERE NUMERO = 4;
DELETE FROM TESTJRN/TESTABLE WHERE NUMERO =3 :
— génération de la fonction table spécifique à votre fichier
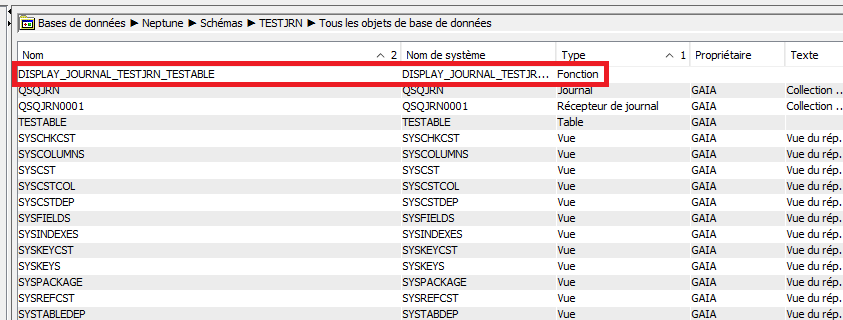
VALUES QSYS2.CREATE_DATA_JOURNAL_READER(LIBRARY_NAME => ‘TESTJRN’,
FILE_NAME => ‘TESTABLE’,
OUTPUT_LIBRARY => ‘TESTJRN’);
— Utilisation de la fonction générée
SELECT * FROM TABLE (TESTJRN.DISPLAY_JOURNAL_TESTJRN_TESTABLE());
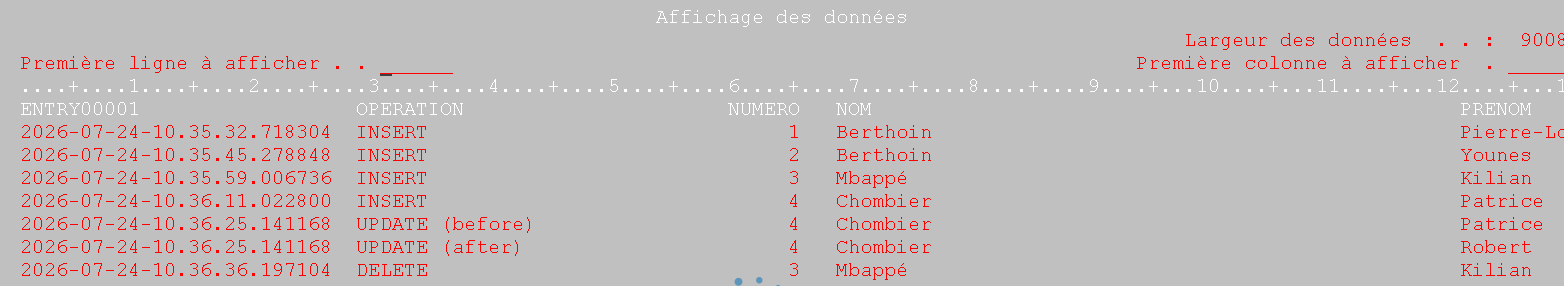
bien sur vous pouvez mettre des filtres sur l’affichage
Les liens à connaitre
https://www.ibm.com/support/pages/qsys2createdatajournalreader
https://www.ibm.com/docs/en/i/7.6.0?topic=function-using-data-journal-reader