https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2023-05-20 08:21:172023-05-20 08:21:18Informations sur les SAVF
Il est possible que vous ayez un effet de bord sur les fichiers téléchargés par FTP ou SFTP par exemple dans vos cpyfrmstmf ou cpyfrmimpf vous avez un plantage.
Les fichiers étaient jusqu’ici encodés en CCSID = 819 et maintenant par défaut, ils sont encodés en CCSID = 1208
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2023-05-12 14:04:002023-05-13 09:42:42Migration en V7R4 et IFS
Premier test sur les fonctions géospatiales, elles sont désormais intégrées à DB2
Vous pouvez indiquer les coordonnées GPS d’un lieu dans une zone, et vous pourrez ensuite faire des calculs, de distance , de superficie, etc …
C’est des zones de type QSYS2.ST_POINT, par exemple pour indiquer des coordonnées GPS, mais vous pouvez également indiquer des formes comme des lignes ou des polygones ..
Voici un premier exemple
— Création table des salariés avec leur lieu de travail
create table GDATA.SALARIE (ID int, NOM varchar(30), PRENOM varchar(30), MAISON QSYS2.ST_POINT, TRAVAIL QSYS2.ST_POINT);
— Insertion dans la table des informations Vous pouvez les trouver ici les coordonnées GPS: https://www.coordonnees-gps.fr/
le gouvernement mais également à disposition un site
INSERT INTO GDATA.DOCTEUR VALUES(3, ‘Docteur3’, ‘Paris’, QSYS2.ST_POINT(‘point (48.8532238 2.3678865)’)
) ;
— Je veux les docteurs à moins de 10 km du domicile du salarié
Select b.nomdoc, b.ville, st_distance(a.maison , b.cabinet) as distance from gdata.salarie a , gdata.docteur b where st_distance(a.maison , b.cabinet) < 10000 ;
Le résultat
Conclusions :
Il y a des fonctions beaucoup plus poussées, et on imagine bien le type d’application qu’on pourra faire, donc on peut prévoir dès à présent une zone de géolocalisation dans des fichiers clients qu’on va créer, voir modifier .
Quand un travail démarre, il crée dans la log système un message CPF1124 et un message CPF1164 quand il se termine.
C’est comme ca qu’on sait qu’un job à tourné
Mais attention, Il existe des travaux pour lesquels les messages CPF1124 et CPF1164 ne sont pas logués dans QHST : il s’agit des SPAWN jobs.
Les travaux QP0ZSPWP & QP0ZSPWT en sont de bons exemples.
Spawn batch jobs : https://www.ibm.com/docs/en/i/7.4?topic=jobs-spawn-batch
Spawn est une fonction qui crée un nouveau processus de travail (processus enfant) qui hérite de nombreux attributs du processus appelant (processus parent). Un nouveau programme est spécifié et commence à s’exécuter dans le processus enfant. Lorsque vous lancez un travail par lots, vous utilisez un travail parent pour transmettre des arguments et des variables d’environnement au travail enfant. L’API spawn() utilise des travaux batch immédiats, des travaux pré-démarrés ou des travaux batch pré-démarrés.
Nombre de spools d’un job est fixé globalement par la valeur système QMAXSPLF. Elle est par défaut à 9999 et le maximum 999999 sont changement ne nécessite pas d’IPL.
Il est possible que pour un job cette valeur soit insuffisante pour un asynchrone par exemple qui est chargé de faire de l’impression.
Vous recevrez le message CPF4167
Vous pouvez augmenter cette limite en utilisant une variable d’environnement QIBM_SP_MAXSPLF
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2023-04-14 06:42:392023-04-14 14:19:45Nombre maximum de spools par JOB
WITH dbmon1 (QQRID, total1) AS (
         SELECT QQRID,
                COUNT(*)
             FROM votrebib.QZGxxxxxx     << monitor 1
             GROUP BY QQRID
     ),
     dbmon2 (QQRID, total2) AS (
         SELECT QQRID,
                COUNT(*)
             FROM votrebib.QZGyyyyyyy     << monitor 2
             GROUP BY QQRID
     )
    SELECT dbmon1.QQRID,
           dbmon1.total1,
           dbmon2.total2
        FROM dbmon1
             JOIN dbmon2
                 ON dbmon1.QQRID = dbmon2.QQRID
En temps d’exécution
WITH dbmon1 (QQRID, total1) AS (
         SELECT QQRID,
                sum(QQETIM - QQsTIM )
             FROM votrebib.QZGxxxxxxx    << monitor 1
             GROUP BY QQRID
     ),
     dbmon2 (QQRID, total2) AS (
         SELECT QQRID,
                 sum(QQETIM - QQsTIM )
             FROM votrebib.QZGyyyyyyyy   << monitor 2
             GROUP BY QQRID
     )
    SELECT dbmon1.QQRID,
           dbmon1.total1,
           dbmon2.total2
        FROM dbmon1
             JOIN dbmon2
                 ON dbmon1.QQRID = dbmon2.QQRID
Après il vous faudra enquêter sur les différences que vous avez constaté
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2023-04-13 07:08:342023-04-13 07:08:36Comparer 2 monitors de base de données
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2023-04-11 16:43:202023-04-11 22:09:25TR2 pour la V7R5
Si vous n’administré pas au quotidien votre base de données, mais que vous devez intervenir ponctuellement, Vous avez un lien qui référence les principales opérations à faire et qui peut vous aider
https://www.gaia.fr/wp-content/uploads/2017/02/team3.png600600Pierre-Louis BERTHOIN/wp-content/uploads/2017/05/logogaia.pngPierre-Louis BERTHOIN2023-04-10 09:05:432023-04-10 09:05:44Database Information Finder
Les groupes DB2 pour la TR2 de la V7R5 et de la TR8 de la V7R4 sont disponibles, une des nouveautés c’est les vues sur les fichiers de sauvegarde
La première vue sur les SAVF SAVE_FILE_INFO permet d’avoir des informations sur le SAVF
par exemple
vous voulez connaitre les SAVF qui date de plus de 6 mois
select * from QSYS2.SAVE_FILE_INFO
where SAVE_TIMESTAMP < current date – 6 month
order by SAVE_TIMESTAMP desc
Vous pouvez par exemple utiliser la fonction SQL QCMDEXC pour faire le ménage plus d’informations ici
https://www.gaia.fr/qcmdexc-en-fonction-sql/
La deuxième vue sur les objets sauvegardés dans les SAVF, QSYS2.SAVE_FILE_OBJECT permet d’avoir des informations sur les ojets contenus dans le SAVF
Par exemple vous voulez savoir, si un objet est dans une sauvegarde et sa date de sauvegarde
select * from QSYS2.SAVE_FILE_OBJECTS
where OBJECT_NAME = ‘votre objet’ and OBJECT_TYPE = ‘votre type’
order by SAVE_TIMESTAMP desc
Attention
Ces fonctions sont à lancer en batch, c’est des informations qui mettent du temps à être extraites
Il est possible que vous ayez un effet de bord sur les fichiers téléchargés par FTP ou SFTP par exemple dans vos cpyfrmstmf ou cpyfrmimpf vous avez un plantage.
Les fichiers étaient jusqu’ici encodés en CCSID = 819 et maintenant par défaut, ils sont encodés en CCSID = 1208
Le problème est référencé ici
https://www.ibm.com/support/pages/after-v7r4-upgrade-encoding-scheme-not-compatible-utilizing-gifsgatecpyfrmstmf-gentran-server-iseries
En résumé, vous devez rajouter une variable d’environnement et redémarrer vos services
Voici comment ?
// Ajout d’une variable d’environnement
ADDENVVAR ENVVAR(PASE_DEFAULT_UTF8) VALUE(N) LEVEL(*SYS)
// Redémarrage du FTP
STRTCPSVR SERVER(*FTP)
ENDTCPSVR SERVER(*FTP)
// Redémarrage du SFTP
ENDTCPSVR SERVER(*SSHD)
STRTCPSVR SERVER(*SSHD)
Conclusion :
Ca vous permet de contourner le problème, mais le mieux est de passer en unicode donc CCSID = 1208
Premier test sur les fonctions géospatiales, elles sont désormais intégrées à DB2
Vous pouvez indiquer les coordonnées GPS d’un lieu dans une zone, et vous pourrez ensuite faire des calculs,
de distance , de superficie, etc …
C’est des zones de type QSYS2.ST_POINT, par exemple pour indiquer des coordonnées GPS, mais vous pouvez également indiquer des formes comme des lignes ou des polygones ..
Voici un premier exemple
— Création table des salariés avec leur lieu de travail
create table GDATA.SALARIE
(ID int,
NOM varchar(30),
PRENOM varchar(30),
MAISON QSYS2.ST_POINT,
TRAVAIL QSYS2.ST_POINT);
— Insertion dans la table des informations
Vous pouvez les trouver ici les coordonnées GPS:
https://www.coordonnees-gps.fr/
le gouvernement mais également à disposition un site
https://adresse.data.gouv.fr/api-doc/adresse
Vous pouvez interroger par CURL ou API bien sur par API en SQL
Exemple pour Gaia:
sous qsh
curl « https://api-adresse.data.gouv.fr/search/?q=41+rue+diebold&postcode=69009 »
résultat
Dans un browser
https://api-adresse.data.gouv.fr/search/?q=41+rue+Diebold&postcode=69009
INSERT INTO GDATA.SALARIE VALUES(1, ‘Géronimo’, ‘Cohen’,
QSYS2.ST_POINT(‘point (45.7542616 4.9152559)’),
QSYS2.ST_POINT(‘point (45.7726 4.8033)’)
) ;
Par Api
VALUES QSYS2.HTTP_GET(
‘https://api-adresse.data.gouv.fr/search/?q=41+rue+Diebold&postcode=69009’);
— Calculé la distance entre 2 points en mètres
— Représentation en coordonnées des zones
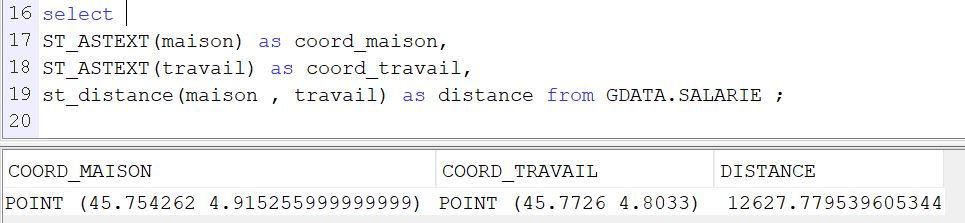
SELECT
ST_ASTEXT(maison) as coord_maison,
ST_ASTEXT(travail) as coord_travail,
st_distance(maison , travail) as distance from GDATA.SALARIE ;
Résultat :
.
Vous pouvez par exemple, facilement calculer les salariés qui habitent à plus de 100 km de leur lieu de travail.
SELECT « ID », NOM, PRENOM
from GDATA.SALARIE
where st_distance(maison , travail) > 100000 ;
On complète
— Création table des docteurs
create table GDATA.DOCTEUR
(ID int,
NOMDOC varchar(30),
VILLE varchar(30),
CABINET QSYS2.ST_POINT);
— insertion d’une liste de docteurs
INSERT INTO GDATA.DOCTEUR VALUES(1, ‘Docteur1’, ‘Lyon’,
QSYS2.ST_POINT(‘point (45.7679223 4.8445736)’)
) ;
INSERT INTO GDATA.DOCTEUR VALUES(2, ‘Docteur2’, ‘Marseille’,
QSYS2.ST_POINT(‘point (43.2978337 5.3693324)’)
) ;
INSERT INTO GDATA.DOCTEUR VALUES(3, ‘Docteur3’, ‘Paris’,
QSYS2.ST_POINT(‘point (48.8532238 2.3678865)’)
) ;
— Je veux les docteurs à moins de 10 km du domicile du salarié
Select b.nomdoc, b.ville, st_distance(a.maison , b.cabinet) as distance
from gdata.salarie a , gdata.docteur b
where st_distance(a.maison , b.cabinet) < 10000 ;
Le résultat
Conclusions :
Il y a des fonctions beaucoup plus poussées, et on imagine bien le type d’application qu’on pourra faire, donc on peut prévoir dès à présent une zone de géolocalisation dans des fichiers clients qu’on va créer, voir modifier .
Plus d’informations ici
https://www.ibm.com/docs/en/i/7.5?topic=analytics-geospatial-functions
Vous avez un spool généré et vous voulez le modifier, bien sur si vous pouvez agir avant la génération du spool c’est mieux.
Imaginons que vous ne pouvez pas le faire, voici la procédure en quelques étapes pour réaliser cette opération.
Vous devez créer un fichier qui a la longueur de votre spool + 1
CRTPF QTEMP/SPOOLPF RCDLEN(longueur + 1)
Ensuite vous avez besoin d’identifier votre spool
nom_spool, Numero_job, Utilisateur, Nom_job et numero_spool (souvent , on peut utiliser *LAST)
Vous allez copier votre spool en idiquant bien *FCFC
CPYSPLF FILE(NOM_SPOOL) TOFILE(QTEMP/SPOOLPF)
JOB(NUMERO_JOB/UTILISATEUR/NOM_JOB)
SPLNBR(LAST) CTLCHAR(*FCFC)
Vous pouvez alors modifier votre ficher DB généré, par SQL, DFU ou par programme
Votre fichier est modifié, vous allez devoir le recopier pour regénérer un spool.
D’abord, indiquez que vous avez besoin des caractères de contrôle
OVRPRTF FILE(NOM_SPOOL) CTLCHAR(*FCFC)
Transformation de votre fichier DB en SPOOL
CPYF FROMFILE(QTEMP/SPOOLPF) TOFILE(NOM_SPOOL)
Vous pouvez à nouveau gérer votre spool, exemple pour le changer de file :
CHGSPLFA FILE(NOM_SPOOL) JOB(NUMERO_JOB/UTILISATEUR/NOM_JOB)
SPLNBR(*LAST) OUTQ(TLXOFC/FAX)
Conclusion :
Ca reste du bricolage, mais ca peut dépanner.
Quand un travail démarre, il crée dans la log système un message CPF1124 et un message CPF1164 quand il se termine.
C’est comme ca qu’on sait qu’un job à tourné
Mais attention, Il existe des travaux pour lesquels les messages CPF1124 et CPF1164 ne sont pas logués dans QHST : il s’agit des SPAWN jobs.
Les travaux QP0ZSPWP & QP0ZSPWT en sont de bons exemples.
Spawn batch jobs : https://www.ibm.com/docs/en/i/7.4?topic=jobs-spawn-batch
Spawn est une fonction qui crée un nouveau processus de travail (processus enfant) qui hérite de nombreux attributs du processus appelant (processus parent). Un nouveau programme est spécifié et commence à s’exécuter dans le processus enfant. Lorsque vous lancez un travail par lots, vous utilisez un travail parent pour transmettre des arguments et des variables d’environnement au travail enfant. L’API spawn() utilise des travaux batch immédiats, des travaux pré-démarrés ou des travaux batch pré-démarrés.
https://www.ibm.com/docs/en/i/7.4?topic=ssw_ibm_i_74/apis/spawn.htm
https://www.ibm.com/docs/en/i/7.4?topic=programs-example-using-process-related-apis
Ca peut être le cas aussi pour les jobs QCTXDMON (IBM transformer)
plus rigolo
Vous pouvez demander à supprimer ces messages
Pour cela vous devez créer une dtaara QWTFMSG dans QUSRSYS :
CRTDTAARA DTAARA(QUSRSYS/QWTFMSG) TYPE(*CHAR) LEN(14) VALUE(‘CPF1124CPF1164’)
Cette valeur est prise en compte au démarrage de vos sous systémes
elle est globale c’est dommage qu’on ne puisse préciser un sous système
Attention
Beaucoup d’outils d’analyse utilise ces messages pour vérifier le bon traitement d’une tache
Nombre de spools d’un job est fixé globalement par la valeur système QMAXSPLF.
Elle est par défaut à 9999 et le maximum 999999 sont changement ne nécessite pas d’IPL.
Il est possible que pour un job cette valeur soit insuffisante pour un asynchrone par exemple qui est chargé de faire de l’impression.
Vous recevrez le message CPF4167
Vous pouvez augmenter cette limite en utilisant une variable d’environnement QIBM_SP_MAXSPLF
ADDENVVAR ENVVAR(QIBM_SP_MAXSPLF)
VALUE(99999)
LEVEL(*JOB)
Pour voir les variables d’environnement d’un travail WRKENVVAR
OU DSPJOB puis option 22
ou
DSPJOB OPTION(*ENVVAR)
Attention, bien mettre *JOB pour limiter la portée de la modification au travail
Conseil :
Il n’est pas conseillé de changer la valeur système QMAXSPLF qui vous protégé d’un job qui boucle
Vous avez collecté 2 monitors de base de données, du genre avant après une mise en prod et vous voulez les comparer
La première solution est d’utiliser ACS
SQL Performance Center
Moniteur de performances
Mais vous pouvez faire des opérations assez similaire en utilisant SQL
https://www.ibm.com/docs/en/i/7.4?topic=formats-sql-table
Voici 2 exemples de requêtes
En nombre en ID record
En temps d’exécution
Après il vous faudra enquêter sur les différences que vous avez constaté
Exemple :
Avec l’ID , 3002 vous aurez les indexs à créer
Vous voulez récupérer les requêtes SQL exécutées sous une session interactive
Si vous pouvez vous connecter sous le profil c’est relativement simple
Connectez vous sous le profil et sous STRSQL faites <F13>
Vous pouvez indiquer un fichier avec différentes options, le fichier par défaut s’appelle QSQLSESS de QGPL
La difficulté existe, si vous ne pouvez pas vous connecter sous le profil en effet ces informations sont stockées dans le profil.
Pour les voir vous devrez donc utiliser la commande DMPSYSOBJ
Comme ceci
DMPSYSOBJ OBJ(‘ISQLSTvotreuser*’) +
CONTEXT(QRECOVERY) TYPE(19) SUBTYPE(EE)
Vous obtenez un spool QPSRVDMP que vous pourrez analyser
Bien sur vous devez avoir le droit de dumper et le droit sur le profil
Pour vous aider nous avons fait un outil DMPSQLUSR que vous pouvez trouvez ici https://github.com/Plberthoin/PLB/tree/master/GTOOLS
Il n’est pas parfait, mais il produit un fichier SQLLISTE dans QTEMP qui contiendra toutes instructions exécutées
Rappel :
Vous pouvez également retrouver des informations sur l’exécution des requêtes dans des moniteurs DB ou dans le cache SQL.
Les annonces de la TR2 pour la V7R5 sont sorties
Voici quelques infos sur les nouveauté de la TR
des nouvelles vues SQL
par exemple pour manipuler les fichiers SAVF
QSYS2.SAVE_FILE_INFO
QSYS2.SAVE_FILE_OBJECTS
sur les audits
Nouvelles fonctions table AUDIT_JOURNAL_XX pour analyser les types suivants
AP, AX, OR, PA, PF, PU, RA, RO, and RZ
ZLIB supporté par SQE
Sur DB2 , nouvelles fonctions SQL pour manipuler les dates et les heures
ADD_DAYS scalar function
ADD_HOURS scalar function
ADD_MINUTES scalar function
ADD_SECONDS scalar function
ADD_YEARS scalar function
Mais la principale nouveauté c’est l’arrivée de
Geospatial Analytics dans DB2 , c’est celle de Watson
https://www.ibm.com/docs/en/i/7.5?topic=analytics-best-practices-considerations
Vous voulez une définition regardez ici
https://fr.wikipedia.org/wiki/Analyse_spatiale
Ca préfigure de grosses nouveautés en matière d’analyse de données
RDV pour les premiers tests
plus d’informations ici
https://www.ibm.com/support/pages/ibm-i-75-tr2-enhancements
Si vous n’administré pas au quotidien votre base de données, mais que vous devez intervenir ponctuellement,
Vous avez un lien qui référence les principales opérations à faire et qui peut vous aider
https://www.ibm.com/docs/en/i/7.5?topic=database-information-finder
Vous avez 5 manières de chercher
DB2 tasks
SQL quick reference
DB2 and SQL examples
SQL statements
DB2 topics
Sélectionner l’information dans la liste et faite GO
Nous on utilise souvent la première
DB2 tasks
Vous voulez ajouter une zone, Appuyer vers Go, ca vous emmènera vers des liens qui référencera les opérations à effectuées.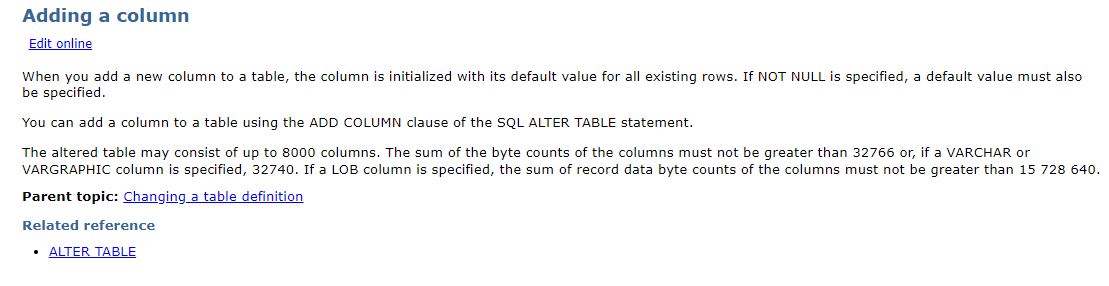
Rappel :
Pour les exemples, vous avez aussi ACS qui en propose une liste
dans exécution de scripts SQL