Je n’ai pas voulu mettre optimisation dans le titre de l’article, c’est pourtant bien ce qui nous est souvent demandé.
Avant de chercher à optimiser les requêtes, il est utile de vérifier que quelques bonnes pratiques de base sont respectées dans l’écriture de la requête !
Dans le cas traité, on s’intéresse particulièrement à plusieurs éléments :
- critères de jointure
- critères de sélection
- critères de groupage
Objectif recherché : que tous ces critères soient exprimés, si possible, sans calcul !
Une zone calculée ne peut être prise en charge via un index par l’optimiseur … nous allons donc réécrire tout ce qui a été écrit d’une façon « humaine » !
Exemple
La requête utilisée dans cet article est un extrait d’un requête réelle, pour laquelle les noms de tables et colonnes ont été modifiées …
Critère de jointure
Ce point n’impacte que peu les performances, car le moteur SQL réécrit la requête pour nous, mais apporte plus de lisibilité.
On évite ce genre de syntaxe (produit cartésien) :
SELECT …
FROM ADHENT,
     ADHDET
WHERE (ADHENT.GJCMP = ADHDET.GACMP#
              AND ADHENT.GJGL# = ADHDET.GAGL#A
              AND ADHDET.GAACCD = '1')
          AND ((ADHDET.GATYPE IN (
                      'EX',
                      'IN'
                  ))
Pour exprimer sur la jointure les critères :
select ADHENT.*
 from ADHENT
 join ADHDET ON (ADHENT.GJCMP = ADHDET.GACMP#
               AND ADHENT.GJGL# = ADHDET.GAGL#A
               AND ADHDET.GAACCD = '1')
 WHERE (ADHDET.GATYPE IN (
                       'EX',
                       'IN'
                   )) ;
Critères de sélection
Requête de départ :
select ADHENT.*
 from ADHENT
 join ADHDET ON (ADHENT.GJCMP = ADHDET.GACMP#
               AND ADHENT.GJGL# = ADHDET.GAGL#A
               AND ADHDET.GAACCD = '1')
 WHERE      ADHDET.GATYPE IN ( 'EX', 'IN' )
        AND (ADHENT.GJACMO <> 13)
        AND ADHENT.GJCMP IN ('10')
        AND CASE
              WHEN ADHENT.GJJLDT = 0 THEN '01/01/9999'
              ELSE DATE( SUBSTR(ADHENT.GJJLDT, 5, 2) || '/' ||
                         SUBSTR(ADHENT.GJJLDT, 7, 2) || '/' ||
                         SUBSTR(ADHENT.GJJLDT, 1, 4))
            END BETWEEN '2016-01-01' AND '2017-12-31'
        AND SUBSTR(ADHENT.GJGL#, 1, 6) BETWEEN '615540' AND '615540'
        AND CASE
              WHEN TRIM(ADHENT.GJLTG#) = '' THEN 'N'
              ELSE 'Y'
            END = 'N'
Il est possible de remplacer toutes les valeurs calculées et de les inverser !
   AND CASE
         WHEN ADHENT.GJJLDT = 0 THEN '01/01/9999'
         ELSE DATE( SUBSTR(ADHENT.GJJLDT, 5, 2) || '/' ||
                    SUBSTR(ADHENT.GJJLDT, 7, 2) || '/' ||
                    SUBSTR(ADHENT.GJJLDT, 1, 4))
       END BETWEEN '2016-01-01' AND '2017-12-31'
Devient :
AND ADHENT.GJJLDT between int(date('2016-01-01')) AND int(date('2017-12-31'))
Sélection sur code :
AND SUBSTR(ADHENT.GJGL#, 1, 6) BETWEEN '615540' AND '615540'
Devient :
AND ADHENT.GJGL# BETWEEN '615540' ||'0000000000' AND '615540' || '9999999999'
Sélection sur code :
   AND CASE
         WHEN TRIM(ADHENT.GJLTG#) = '' THEN 'N'
         ELSE 'Y'
       END = 'N'
Devient :
AND ADHENT.GJLTG# = ''
Ce dernier exemple illustre bien la capacité du cerveau humain à raisonner et non pas à exprimer des critères techniques !
Critères de groupage (et mise en forme)
Le groupage est souvent effectué en dernier, c’est-à-dire après l’ensemble des jointures. Vous êtes alors contraints d’ajouter un nombre important de colonnes dans le groupage, colonnes faisant l’objet de mise en forme pour un affichage adapté à l’utilisateur, et donc sur des zones calculées !
Nous proposons l’inverse :
- d’abord on calcule les données, nécessitant groupage
- ensuite on va chercher, par des jointures, des éléments complémentaires et on met en forme (calcul) les valeurs
Pour cela les CTE (Common Table Expressions) nous sont d’un grand secours.
Par exemple :
with tmp as (
   SELECT ADHENT.GJCMP,
          ADHENT.GJGL#,
          ADHENT.GJJLTP,
          ADHENT.GJJLCD,
          ADHENT.GJJLNO,
          ADHENT.GJINV#,
          ADHENT.GJDESC,
          ADHENT.GJJLDT,
          ADHENT.GJMVM#,
          ADHENT.GJTYPE,
          ADHENT.GJLTG#,
          ADHENT.GJLTGD,
          SUM(ADHENT.GJAMT$) as somme1,
          SUM( CASE
                 WHEN ADHENT.GJAMT$ > 0.00 THEN ADHENT.GJAMT$
               END) as somme2,
          SUM(
               CASE
                 WHEN ADHENT.GJAMT$ < 0.00 THEN (-1 * ADHENT.GJAMT$)
               END) as somme3
   from ADHENT
   join ADHDET ON ...
   WHERE ...
   GROUP BY ADHENT.GJCMP,
            ADHENT.GJGL#,
            ADHENT.GJJLTP,
            ADHENT.GJJLCD,
            ADHENT.GJJLNO,
            ADHENT.GJINV#,
            ADHENT.GJDESC,
            ADHENT.GJJLDT,
            ADHENT.GJMVM#,
            ADHENT.GJTYPE,
            ADHENT.GJLTG#,
            ADHENT.GJLTGD )

select tmp.GJCMP,
        SUBSTR(tmp.GJGL#, 7, 4),
        SUBSTR(tmp.GJGL#, 1, 6),
        tmp.GJJLTP,
        tmp.GJJLCD || '-' || RIGHT(CONCAT('00000000', TRIM(CHAR(tmp.GJJLNO))), 8),
        tmp.GJJLNO,
        TRIM(tmp.GJINV#),
        tmp.GJDESC,
        CASE WHEN tmp.GJJLDT = 0 THEN '01/01/9999'
             ELSE DATE( SUBSTR(tmp.GJJLDT, 5, 2) || '/' ||
                        SUBSTR(tmp.GJJLDT, 7, 2) || '/' ||
                        SUBSTR(tmp.GJJLDT, 1, 4))
        END,
        tmp.GJMVM#,
        TRIM(tmp.GJTYPE),
        tmp.GJLTG#,
        tmp.GJGL#,
        ADHCMP1.ZLARGN,
        TRIM(ADHCMP2.ZRNAME),
        CASE WHEN tmp.GJLTGD = 0 THEN '01/01/9999'
             ELSE DATE( SUBSTR(tmp.GJLTGD, 5, 2) || '/' ||
                        SUBSTR(tmp.GJLTGD, 7, 2) || '/' ||
                        SUBSTR(tmp.GJLTGD, 1, 4))
        END,
        somme1,
        somme2,
        somme3
 from tmp
   LEFT OUTER JOIN ADHCMP1 ON ADHCMP1.ZLCMP  = tmp.GJCMP
                           AND ADHCMP1.ZLLOC  = SUBSTR(tmp.GJGL#, 7, 4)
   LEFT OUTER JOIN ADHCMP2 ON ADHCMP1.ZLCMP  = ADHCMP2.ZRCMP
                           AND ADHCMP1.ZLIRGN = ADHCMP2.ZRRGN ;
Avec ces quelques règles, simples dans leur principe, vous vous assurez que le moteur SQL pourra utiliser pleinement vos index. Cela ne signifie pas qu’il ne sera pas nécessaire d’optimiser par la suite.
Pour finir le cas concret évoqué ici :
– 4 fichiers dans la jointures :
– 500 Millions , 1 Million, 1.000 et 70 enreg
– 4.600 enreg en retour
Requête d’origine : 2 min 40 s (ce qui est déjà très bien, avec un scan de table sur le plus gros fichier).
Après réécriture : 40 ms
Bien sûr, les index nécessaires étaient déjà en place pour atteindre ce niveau de temps de réponse.
Encore une fois, SQL est le meilleur moyen d’accéder à la donnée, aussi complexe soit elle.
Par le meilleur, j’entends :
- le plus simple : écrire un programme RPG/COBOL équivalent demanderait une quantité de code importante (et donc probabilité de bug)
- le plus efficace (40 ms) : à condition que l’on donne à SQL les moyens d’être efficace
En conclusion : travailler d’abord sur la donnée, occupez vous ensuite de la mise en forme !
La commande STRDBMON vous permet de lancer des moniteurs de base de données, si vous lancez un moniteur privé (sur le travail en cours), il prendra fin quand le job se terminera.
Mais si vous lancez un moniteur public pour tous les travaux par exemple, comment l’arrêter, vous pouvez vouloir un moniteur tous les jour de 14h à 18h pour analyser les JOB ODBC ou autres.
Nous proposons un petit code que vous pourrez améliorer qui fera cette opération :
Vous pouvez indiquer la bibliothèque et le fichier de sortie pour le monitor et le temps d’exécution en secondes
Vous pouvez changer les filtres au niveau du STRDBMON en précisant ce que vous voulez analyser
vous pouvez faire une commande comme ceci pour lancer plus facilement votre programme !
Conclusion
Vous pouvez le planifier dans votre Scheduler et indiquer par exemple un nom de fichier DBMAAMMJJ pour chaque jour, vous pourrez ainsi comparer au fil du temps ce qui ce passe sur cette période dans votre base de données.
Attention à bien le soumettre dans une file qui ne bloquera pas vos traitements, par exemple QSYSNOMAX ou QUSRNOMAX
Il existe 2 solutions pour gérer vos spools sans passer par un écran 5250, je vais vous les présenter.
La première solution est ACS
Vous devez avoir le java bundle sur votre PC.
Vous cliquez sur Sortie imprimante
Vous avez une grande possibilité de filtres par défaut vous voyez les spools de votre utilisateur.
En faisant un clic droit vous avez un menu qui va vous permettre de gérer vos spools, vous pouvez facilement
télécharger votre spool , il sera converti au format PDF.
La deuxième solution est Navigator for i
Se service d’administration doit être démarré
Vous devez choisir « Mes sorties imprimante »
Vous arrivez sur les spools de votre utilisateurs
Vous pouvez
Convertir en PDF
Si vous choisissez exporter, le fichier obtenu sera au format TXT
en choisissant avancé, vous pouvez gérer votre imprimante
Conclusion :
Les principales différences sont
ACS
Plus de filtres
NFI
Possibilité de convertir en txt
Possibilité de gérer l’imprimante
Préambule
Cet article est une suite à l’article de Pierre-Louis BERTHOIN qui présente les fonctions géospatiales intégrées à DB2.
Choix de l’API
Sur le site https://adresse.data.gouv.fr/ En cliquant sur l’item « Outils et API », on accède librement à la documentation des API en rapport avec les adresses. Nous choisissons donc celle sobrement intitulée « API Adresse ». La documentation montre différentes manières d’utiliser cette API. Le retour est un geojson FeatureCollection respectant la spec GeoCodeJSON.
Récupération et manipulation des données
But du programme
Nous allons réaliser un programme qui permettra, en écrivant partiellement une adresse, de récupérer une adresse complète d’après une liste déroulante de 50 occurrences.
Nous choisirons pour notre programme une interrogation relativement simple et nous n’extrairons qu’une partie des données du geojson.
Nous écrirons les adresses dans un fichier, sous forme d’une fiche client contenant les éléments suivants :
Préparation du fichier
Programme de saisie
**free ctl-opt dftactgrp(*no) ; // Fichiers dcl-f FORMCLIE workstn indds(DS_Ind) usropn; // Procédures dcl-pr Touche_F4 EXTPGM('TOUCHE_F4'); p_Sql char(1024) ; p_Titre char(35); p_Ret char(116); end-pr; // Variables dcl-s reqSqlDelete varchar(2000); dcl-s reqSqlCreate varchar(2000); dcl-s reqSqlDrop varchar(2000); dcl-s coordonees varchar(64) ; dcl-s queryapi varchar(64); dcl-s httpText varchar(256); dcl-s pIndicators Pointer Inz(%Addr(*In)); // Pour F4 : liste des fichiers dcl-s w_Sql char(1024) ; dcl-s w_Titre char(35); dcl-s w_Ret char(116); // DS Informations Programme dcl-ds *N PSDS; nom_du_pgm CHAR(10) POS(1); nom_du_prf CHAR(10) POS(358); end-ds; // Déclaration des indicateurs de l'écran Dcl-DS DS_Ind based(pIndicators); Ind_Sortie ind pos(3); Ind_Liste ind pos(4); Ind_Annuler ind pos(12); Ind_Valider ind pos(17); Ind_SFLCLR ind pos(40); Ind_SFLDSP ind pos(41); Ind_SFLDSPCTL ind pos(42); Ind_SFLEnd ind pos(43); Ind_DisplayCoord ind pos(80); Ind_RaisonS ind pos(81); Ind_5Lettres ind pos(82); Ind_CodePos ind pos(84); Ind_Ville ind pos(85); Indicators char(99) pos(1); End-DS; // Paramètres en entrée dcl-pi *N; end-pi; // SQL options --------------------------------------------- // Exec SQL Set Option Naming=*Sys, Commit=*None, UsrPrf=*User, DynUsrPrf=*User, Datfmt=*iso, CloSqlCsr=*EndMod; //--------------------------------------------------------- // // Contrôle taille écran Monitor; Open FORMCLIE; On-Error; Dsply 'Nécessite un écran 27 * 132'; *inlr=*on; Return; EndMon; Dou Ind_Sortie or Ind_Annuler; znompgm = nom_du_pgm; znomprf = nom_du_prf; Exfmt FMT01; select ; when Ind_Sortie ; leave; when Ind_Annuler; leave; when Ind_Liste; if %len(%trim(zadresse)) <= 4 ; Ind_5Lettres = *on; iter; endif; traitementListe(); when Ind_Valider; if zraisoc = *blanks; Ind_RaisonS = *on ; endif; if zcodpos = *blanks; Ind_CodePos= *on ; endif; if zville = *blanks; Ind_Ville = *on ; endif; if %subst(indicators:81:4) <> '0000'; iter ; endif; Exec SQL insert into MESCLIENTS (RAISOC, ADRESSE, CODEPOS, VILLE, COORDGEO) values (:zraisoc, :zadresse, :zcodpos, :zville, QSYS2.ST_POINT(:zlongit, :zlatit)) ; Ind_DisplayCoord = *off; clear FMT01; endsl ; Enddo; *inlr = *on; //======================================================================== // // Procédures // //======================================================================== // //------------------------------------------------------------------------ // // Nom : rechercheAdresse // // But : lister des adresses recueillies via une API // // à partir d'une chaine de plus de 4 caractères // // Retour : N/A // //------------------------------------------------------------------------ // dcl-proc rechercheAdresse ; dcl-pi *n ; l_httpText varchar(256) value; end-pi; reqSqlDrop = 'drop table QTEMP/WADRESSE' ; Exec sql Execute immediate :reqSqlDrop ; reqSqlCreate = 'create table QTEMP/WADRESSE' + ' (address varchar(128), numero varchar(8), street varchar(128), ' + 'postcode varchar(16), city varchar(64), coordinates blob)' ; Exec sql Execute immediate :reqSqlCreate ; reqSqlDelete = 'delete from QTEMP/WADRESSE' ; Exec sql Execute immediate :reqSqlDelete ; Exec sql insert into QTEMP/WADRESSE (select ltrim(ifnull(numero, '') || ' ' || coalesce(street, locality, '') || ' ' || postcode || ' ' || city), ifnull(numero, ''), coalesce(street, locality, ''), postcode, city, QSYS2.ST_POINT(longitude, latitude) from json_table(QSYS2.HTTP_GET(:l_httpText, ''), '$.features[*]' COLUMNS (numero varchar(8) PATH '$.properties.housenumber', street varchar(128) PATH '$.properties.street', locality varchar(128) PATH '$.properties.locality', name varchar(128) PATH '$.properties.name', municipality varchar(128) PATH '$.properties.municipality', postcode varchar(8) PATH '$.properties.postcode', city varchar(64) PATH '$.properties.city', longitude float PATH '$.geometry.coordinates[0]', latitude float PATH '$.geometry.coordinates[1]')) ); end-proc ; //------------------------------------------------------------------------ // // Nom : traitementListe // // But : Affichage d'une liste de 50 adresses maximum // // Retour : N/A // //------------------------------------------------------------------------ // dcl-proc traitementListe ; queryapi = %scanrpl(' ':'+':%trim(zadresse)) ; httpText ='https://api-adresse.data.gouv.fr/search/?q=' + queryapi + '&limit=50' ; rechercheAdresse(httpText); clear w_ret ; w_sql = 'select address from QTEMP/WADRESSE' ; w_titre = 'Adresses proposées'; touche_f4(W_Sql: W_titre : w_ret) ; if (w_ret <> ' ') ; clear zadresse; clear zcodpos; clear zville; Exec SQL select ltrim(ifnull(numero, '') || ' ' || street), postcode, city, REPLACE( REPLACE(QSYS2.ST_asText(COORDINATES), 'POINT (', ''), ')', '') into :zadresse, :zcodpos, :zville, :coordonees from QTEMP.WADRESSE where address = :w_ret ; if sqlcode = 0 ; Ind_DisplayCoord = *on ; zlongit = %dec(%subst(coordonees: 1 : %scan(' ':coordonees)):15:12) ; zlatit = %dec(%subst(coordonees: %scan(' ':coordonees) + 1 : %len(%trim(coordonees)) - %scan(' ':coordonees)):15:12) ; endif; endif ; end-proc ;Quelques explications sur les fonctions SQL utilisées
Tout d’abord nous choisissons de ne pas utiliser la propriété « label » proposée par l’API Adresse. En effet, si celle-ci semble pratique de prime abord, elle n’est pas toujours significative (voir photo du milieu qui où elle ne contient que le nom de la municipalité)
Nous, préférerons donc reconstituer cette adresse en concaténant des zones que l’on retrouve dans chaque occurrence du fichier JSON.
QSYS2.ST_POINT : Cette fonction est utilisée lors de la collecte des données fournie par l’API Adresse.
Elle permet de transformer les coordonnées longitude, latitude en une variable de type BLOB qui représente un point précis et qui est utilisable par les fonctions Géospatiales du SQL.
QSYS2.ST_ASTEXT : Cette fonction permet de transformer un champ géométrique (ST_POINT, ST_LINESTRING, ST_POLYGON, …) en un champ WKT (well-known-text) qui nous sera plus compréhensible.
Cinématique du programme
Ce programme est un simple écran qui nous permet la saisie d’un formulaire avec la possibilité de rechercher ou compléter une adresse en utilisant la touche F4 (la fonction externe appelée n’est pas décrite dans cet article). Une fois le formulaire validé, on l’efface.
Tout d’abord on commence à remplir le formulaire mais on ne connait pas précisément l’adresse.
Donc, après avoir tapé un morceau d’adresse on presse F4
On valide, le formulaire est alors complétement rempli
On presse F17 pour valider celui-ci (et réinitialiser l’écran).
Vérification des données enregistrées
Version BLOB
Version WKT (well-known-text)
Conclusion
Nous avons montré ici un exemple simple de l’utilisation d’une API couplée avec les fonctions géospatiales proposées par IBM. Il est possible d’envisager des requêtes plus complexes incluant le code postal, la ville ou encore le type de donnée (rue, lieu-dit ou municipalité). On peut aussi envisager des requêtes d’après les coordonnées géographiques pour retrouver une adresse. Le champ des possibles, comme le monde, est vaste …
Vous voulez savoir immédiatement quand un fichier PF ou table est créé dans votre bibliothèque
4 principales techniques sont à votre disposition,
La première, les programmes d’exit
QIBM_QCA_CHG_COMMAND pour
CRTPF
CRTDUPOBJ
CPYF
MOVOBJ
RSTOBJ
QIBM_QZDA_SQL1 ou QIBM_QZDA_SQL2
Pour les create table SQL
Attention sera appelé pour chaque requête SQL sur votre système
et la syntaxe peut être compliqué
La deuxième technique consiste à utiliser la journalisation
Si votre bibliothèque est journalisée
— Mise en plage des règles d’héritages
— pour avoir tous les événnements, ce qui n’est pas le cas par défaut
ENDJRNLIB LIB(votre bib)
STRJRNLIB LIB(votre bib)
JRN(votre bib/votre journal)
INHRULES((*ALL *ALLOPR *INCLUDE *BOTH *OPNCLO))
Protocole de test
CREATE TABLE
code D Type CT
CRTPF
code D Type CT
CRTDUPOBJ
code D Type CT
MOVOBJ OBJ(GAIA/APF3) OBJTYPE(*FILE) TOLIB(GDATA)
Pas de poste est le fichier n’est pas journalisé
CPYF
code D type CT
RSTOBJ
Pas de poste et le fichier n’est pas journalisé
il est journalisé que si c’est une restauration de lui même, paramètre du RSTOBJ … STRJRN(*YES)
vous pourrez faire un programme d’exit sur le journal pour les code D type CT
mais attention donc
donc pas de poste pour les MOVOBJ et les RSTOBJ
La troisième technique est d’utiliser le journal d’audit
s’il est démarré et qu’il a la valeur *CREATE, vous allez avoir des postes code T type CO pour les créations
et OR, RA, RO pour les restaurations
Vous pourrez faire un programme d’exit sur le journal d’audit pour les postes vues ci dessous,
remarque les outils de replication logiciel utilise cette techno.
La quatrième, le journal du catalogue DB2
Le catalogue bénéficie de son propre journal, QDBJRNFILE de la Bibliothèque QRECOVERY
Quand vous créez une table ou un PF, vous avez un poste code R type PT ou PX qui sont générés
Vous pouvez mettre en place un programme d’exit journal sur celui ci
C’est une solution simple et efficace
Conclusion
Pas de solution miracle
si votre base est journalisée utiliser la solution 2 semble la plus simple
surtout que dans certain cas on ne voudra pas tracer les MOVOBJ et les RSTOBJ
Dans la dernière TR est apparue une nouveauté très intéressante « API RSE », c’est un ensemble d’API REST fournies avec votre système d’exploitation au travers du serveur ADMIN5.
Ces APIs sont utilisables depuis le web et permettent de lancer des commandes, accéder à l’IFS, de lancer de requêtes SQL…
Ce service ne fonctionne qu’en TLS vous devrez donc le sécuriser par l’administration http ://Votre_systeme:2001/HTTPAdmin
Vous devez ensuite le démarrer s’il ne l’est pas c’est le serveur ADMIN5
==>STRTCPSVR SERVER(*IAS) INSTANCE(admin5)
Ce serveur tourne par défaut sur le port 2012
https://Votre_systeme:2012/openapi/ui/
Vous devrez vous authentifiez pour commencer utilisez un user et un mot de passe ibmi, vous cliquez sur authorize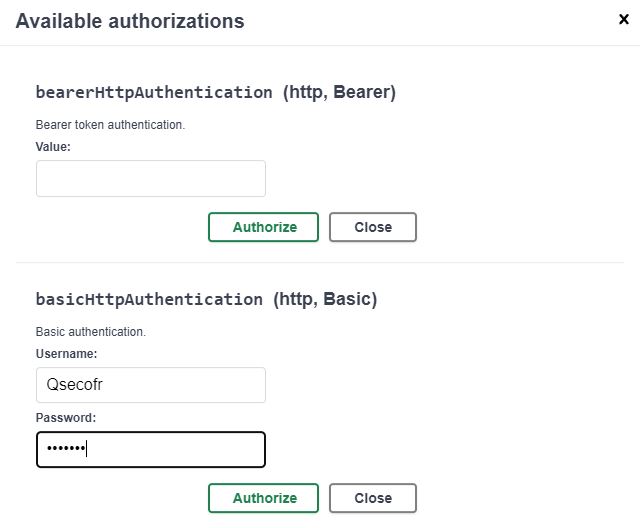
Nous allons tester une commnde CL
Vous cliquez sur try input
Vous avez un flux json avec vos commandes IBMI à l’intérieur vous cliquez sur execute
Vous avez alors le résultat
A noter que vous avez le lien, en haut pour l’intégrer dans vos applications
Conclusion
C’est gratuit c’est technologies actuelles, testez les possibilités de ce service
Pour en savoir plus
la pause café de volubis ici : https://www.volubis.fr/Pausecaf/PAUSECAF91.html
le site IBM : https://www.ibm.com/support/pages/node/6982701
Il existe un produit sur #IBMi qui permet d’indexer des fichiers DB (zones), des spools, des membres sources et l’IFS.
De plus en plus vous utilisez l’IFS et il peut être intéressant d’indexer les fichiers utilisateurs dans /HOME par exemple,
voici ce qu’il vous faudra faire pour démarrer avec cette solution.
Vous devez avoir le produit (gratuit) 5733OMF
la page IBM est ici
https://www.ibm.com/support/pages/omnifind-ibm-i
Vous avez plusieurs services SQL qui vont vous permettre d’administrer ce serveur
1) Vous devrez d’abord le démarrer
Vous avez un server par défaut c’est le 1
call sysproc.systs_start(1)
Pour voir si votre server est démarré vous avez un service SQL
SELECT substr(SERVERNAME, 1, 30) as serveur
, SERVERSTATUS FROM QSYS2.SYSTEXTSERVERS
Attention 0 indique démarré et 1 arrêté
vous pouvez lui donner un nom comme ceci
UPDATE QSYS2/SYSTEXTSERVERS SET SERVERNAME = ‘NOM_SERVEUR’ WHERE
SERVERID = 1
2) Vous devez créer une collection qui contiendra les éléments nécessaires à l’administration et les index par exemple
create collection omnifind
CALL SYSPROC.SYSTS_CRTCOL(‘OMNI_COL’,‘FORMAT INSO’)
Vous pouvez indiquer la fréquence de mise à jour, par défaut, pas de mise à jour automatique.
3) Vous allez ensuite créer un index, ici un index sur l’IFS
Si vous voulez indexer /HOME et les sous répertoires vous devrez utiliser la procédure suivante
SET schema pour mettre OMNI_COL comme collection par défaut
CALL MYCOLLECTION.ADD_IFS_STMF_OBJECT_SET(‘/home/’);
3) Vous allez devoir lancer la mise à jour de l’indexation
call SYSPROC.SYSTS_UPDATE(‘OMNI_COL’ , ‘IFS_OMNI_COL’)
ca peut prendre du temps
4) Vous avez une procédure qui permet de rechercher SEARCH
Vous devrez être autorisé à cette procédure
SET CURRENT SCHEMA OMNI_COL
GRANT EXECUTE ON PROCEDURE SEARCH(VARCHAR) TO QPGMR
set schema omni_col ;
CALL SEARCH(‘TEXT’)
la procédure vous renvoi un result SET que vous pouvez intégrer dans un programme RPGLE par exemple
5) Vous pouvez utiliser un dictionnaire de synonyme
Le fichier modèle se trouvera ici
/QOpenSys/QIBM/ProdData/TextSearch/server1/config/spell/Synonymes.xml
Pour importer
Vous devrez connaitre le nom de la collection
select * from qsys2.systextindexes
Puis passer le scripte sh suivant pour faire l’importation
QSH
cd /Qopensys/QIBM/ProdData/TextSearch/server1/bin
synonymTool.sh importSynonym
-synonymFile /QOpenSys/QIBM/ProdData/TextSearch/server1/config/spell/Synonymes.xml
-collectionName ‘nom_votre_collection’ true
-configPath /QOpenSys/QIBM/ProdData/TextSearch/server1/config
Quand vous rechercherez cheval, vous aurez les fichiers qui ont également chevaux dans le texte
Conclusion:
Ca peut être intéressant d’utiliser ce type d’index pour améliorer la performance de recherche
le produit est gratuit testez le !
3 bonnes pratiques d’écriture de requête SQL !
Je n’ai pas voulu mettre optimisation dans le titre de l’article, c’est pourtant bien ce qui nous est souvent demandé.
Avant de chercher à optimiser les requêtes, il est utile de vérifier que quelques bonnes pratiques de base sont respectées dans l’écriture de la requête !
Dans le cas traité, on s’intéresse particulièrement à plusieurs éléments :
Objectif recherché : que tous ces critères soient exprimés, si possible, sans calcul !
Une zone calculée ne peut être prise en charge via un index par l’optimiseur … nous allons donc réécrire tout ce qui a été écrit d’une façon « humaine » !
Exemple
La requête utilisée dans cet article est un extrait d’un requête réelle, pour laquelle les noms de tables et colonnes ont été modifiées …
Critère de jointure
Ce point n’impacte que peu les performances, car le moteur SQL réécrit la requête pour nous, mais apporte plus de lisibilité.
On évite ce genre de syntaxe (produit cartésien) :
SELECT … FROM ADHENT, ADHDET WHERE (ADHENT.GJCMP = ADHDET.GACMP# AND ADHENT.GJGL# = ADHDET.GAGL#A AND ADHDET.GAACCD = '1') AND ((ADHDET.GATYPE IN ( 'EX', 'IN' ))Pour exprimer sur la jointure les critères :
Critères de sélection
Requête de départ :
Il est possible de remplacer toutes les valeurs calculées et de les inverser !
AND CASE WHEN ADHENT.GJJLDT = 0 THEN '01/01/9999' ELSE DATE( SUBSTR(ADHENT.GJJLDT, 5, 2) || '/' || SUBSTR(ADHENT.GJJLDT, 7, 2) || '/' || SUBSTR(ADHENT.GJJLDT, 1, 4)) END BETWEEN '2016-01-01' AND '2017-12-31'Devient :
AND ADHENT.GJJLDT between int(date('2016-01-01')) AND int(date('2017-12-31'))Sélection sur code :
Devient :
Sélection sur code :
AND CASE WHEN TRIM(ADHENT.GJLTG#) = '' THEN 'N' ELSE 'Y' END = 'N'Devient :
Ce dernier exemple illustre bien la capacité du cerveau humain à raisonner et non pas à exprimer des critères techniques !
Critères de groupage (et mise en forme)
Le groupage est souvent effectué en dernier, c’est-à-dire après l’ensemble des jointures. Vous êtes alors contraints d’ajouter un nombre important de colonnes dans le groupage, colonnes faisant l’objet de mise en forme pour un affichage adapté à l’utilisateur, et donc sur des zones calculées !
Nous proposons l’inverse :
Pour cela les CTE (Common Table Expressions) nous sont d’un grand secours.
Par exemple :
with tmp as ( SELECT ADHENT.GJCMP, ADHENT.GJGL#, ADHENT.GJJLTP, ADHENT.GJJLCD, ADHENT.GJJLNO, ADHENT.GJINV#, ADHENT.GJDESC, ADHENT.GJJLDT, ADHENT.GJMVM#, ADHENT.GJTYPE, ADHENT.GJLTG#, ADHENT.GJLTGD, SUM(ADHENT.GJAMT$) as somme1, SUM( CASE WHEN ADHENT.GJAMT$ > 0.00 THEN ADHENT.GJAMT$ END) as somme2, SUM( CASE WHEN ADHENT.GJAMT$ < 0.00 THEN (-1 * ADHENT.GJAMT$) END) as somme3 from ADHENT join ADHDET ON ... WHERE ... GROUP BY ADHENT.GJCMP, ADHENT.GJGL#, ADHENT.GJJLTP, ADHENT.GJJLCD, ADHENT.GJJLNO, ADHENT.GJINV#, ADHENT.GJDESC, ADHENT.GJJLDT, ADHENT.GJMVM#, ADHENT.GJTYPE, ADHENT.GJLTG#, ADHENT.GJLTGD ) select tmp.GJCMP, SUBSTR(tmp.GJGL#, 7, 4), SUBSTR(tmp.GJGL#, 1, 6), tmp.GJJLTP, tmp.GJJLCD || '-' || RIGHT(CONCAT('00000000', TRIM(CHAR(tmp.GJJLNO))), 8), tmp.GJJLNO, TRIM(tmp.GJINV#), tmp.GJDESC, CASE WHEN tmp.GJJLDT = 0 THEN '01/01/9999' ELSE DATE( SUBSTR(tmp.GJJLDT, 5, 2) || '/' || SUBSTR(tmp.GJJLDT, 7, 2) || '/' || SUBSTR(tmp.GJJLDT, 1, 4)) END, tmp.GJMVM#, TRIM(tmp.GJTYPE), tmp.GJLTG#, tmp.GJGL#, ADHCMP1.ZLARGN, TRIM(ADHCMP2.ZRNAME), CASE WHEN tmp.GJLTGD = 0 THEN '01/01/9999' ELSE DATE( SUBSTR(tmp.GJLTGD, 5, 2) || '/' || SUBSTR(tmp.GJLTGD, 7, 2) || '/' || SUBSTR(tmp.GJLTGD, 1, 4)) END, somme1, somme2, somme3 from tmp LEFT OUTER JOIN ADHCMP1 ON ADHCMP1.ZLCMP = tmp.GJCMP AND ADHCMP1.ZLLOC = SUBSTR(tmp.GJGL#, 7, 4) LEFT OUTER JOIN ADHCMP2 ON ADHCMP1.ZLCMP = ADHCMP2.ZRCMP AND ADHCMP1.ZLIRGN = ADHCMP2.ZRRGN ;Avec ces quelques règles, simples dans leur principe, vous vous assurez que le moteur SQL pourra utiliser pleinement vos index. Cela ne signifie pas qu’il ne sera pas nécessaire d’optimiser par la suite.
Pour finir le cas concret évoqué ici :
– 4 fichiers dans la jointures :
– 500 Millions , 1 Million, 1.000 et 70 enreg
– 4.600 enreg en retour
Requête d’origine : 2 min 40 s (ce qui est déjà très bien, avec un scan de table sur le plus gros fichier).
Après réécriture : 40 ms
Bien sûr, les index nécessaires étaient déjà en place pour atteindre ce niveau de temps de réponse.
Encore une fois, SQL est le meilleur moyen d’accéder à la donnée, aussi complexe soit elle.
Par le meilleur, j’entends :
En conclusion : travailler d’abord sur la donnée, occupez vous ensuite de la mise en forme !
Vous avez besoin de connaitre les niveaux de PTF de 2 systèmes.
Voici comment vous pouvez faire pour comparer les PTF de 2 systèmes, avant on pouvait le faire par Navigator for i – voir le post https://www.gaia.fr/comparer-le-niveau-de-ptf-entre-2-systemes-ibmi/
Pour les groupes
Vous avez la vue QSYS2.GROUP_PTF_INFO
Vous allez devoir comparer les niveaux installés sur les 2 systèmes. Voici comment le faire simplement :
Vous devrez faire une extraction des éléments sur le système à comparer par exemple
create table gaia.remote_ptf as (
select * from QSYS2.GROUP_PTF_INFO
) with data
Vous envoyez le fichier sur la machine cible
select a.PTF_GROUP_NAME, a.PTF_GROUP_LEVEL, b.PTF_GROUP_LEVEL
from QSYS2.GROUP_PTF_INFO a join gaia.remote_ptf b on
A.PTF_GROUP_NAME = B.PTF_GROUP_NAME
pour n’avoir que les différences
select distinct
substr(a.PTF_GROUP_NAME, 1, 30) ,
a.PTF_GROUP_LEVEL, b.PTF_GROUP_LEVEL
from QSYS2.GROUP_PTF_INFO a join gaia.remote_ptf b on
A.PTF_GROUP_NAME = B.PTF_GROUP_NAME
where a.PTF_GROUP_LEVEL <> b.PTF_GROUP_LEVEL
Attention vous avez 2 niveaux de groupe dans le fichier, il faudrait améliorer le script en prenant un max pour avoir le plus haut sur les 2 systèmes
Exemple :
with
LCL (PTF_GROUP_NAME, PTF_GROUP_LEVEL) as
(
SELECT substr(PTF_GROUP_NAME, 1, 20), max(PTF_GROUP_LEVEL) FROM
QSYS2.GROUP_PTF_INFO GROUP BY PTF_GROUP_NAME
),
RMT (PTF_GROUP_NAME, PTF_GROUP_LEVEL) as
(
SELECT substr(PTF_GROUP_NAME, 1, 20), max(PTF_GROUP_LEVEL) FROM
gaia.remote_ptf GROUP BY PTF_GROUP_NAME
)
select A.PTF_GROUP_NAME, A.PTF_GROUP_LEVEL, B.PTF_GROUP_LEVEL
from LCL A join RMT B on A.PTF_GROUP_NAME = B.PTF_GROUP_NAME
Pour les PTF unitaires
Vous avez la vue QSYS2.PTF_INFO, vous pouvez également utiliser un DSPPTF en OUTFILE
Vous allez devoir trouver les PTF manquantes
Vous devrez faire une extraction des éléments sur le système à comparer par exemple
create table gaia.remote_ptf1 as (
select * from QSYS2.PTF_INFO
) with data
Vous envoyez le fichier sur la machine cible
Pour avoir les PTF qui manquent sur le remote :
SELECT a.PTF_PRODUCT_ID, a.PTF_IDENTIFIER
FROM QSYS2.PTF_INFO a exception join
gaia.remote_ptf1 b on
a.PTF_PRODUCT_ID = b.PTF_PRODUCT_ID and
a.PTF_IDENTIFIER = b.PTF_IDENTIFIER
Si voulez les PTF qui manquent sur la source, le plus simple est de changer l’ordre des fichiers :
SELECT a.PTF_PRODUCT_ID, a.PTF_IDENTIFIER
FROM gaia.remote_ptf1 a exception join
QSYS2.PTF_INFO b on
a.PTF_PRODUCT_ID = b.PTF_PRODUCT_ID and
a.PTF_IDENTIFIER = b.PTF_IDENTIFIER
Remarque :
Vous pourriez utiliser une connexion DRDA pour comparer vos fichiers sans les envoyer, si c’est paramétré chez vous
exemple :
select distinct
substr(a.PTF_GROUP_NAME, 1, 30) ,
a.PTF_GROUP_LEVEL, b.PTF_GROUP_LEVEL
from QSYS2.GROUP_PTF_INFO a join Votresystéme.QSYS2.GROUP_PTF_INFO b on
A.PTF_GROUP_NAME = B.PTF_GROUP_NAME
where a.PTF_GROUP_LEVEL <> b.PTF_GROUP_LEVEL
Mai ca ne marche pas vous ne pouvez pas joindre un système avec un distant vous devrez créer une table local
exemple :
create table qtemp/votre bib as (
select * from Votresystéme.QSYS2.GROUP_PTF_INFO
) With Data
Vous avez des outils comme ARE qui permettent également de faire ce type d’opération
un lien avec un exemple DSPPTF OUTFILE
https://www.ibm.com/support/pages/ptfs-comparing-ptfs-between-systems
Il existe plusieurs solutions pour faire du CSV, la plus connue c’est en utilisant la commande CPYTOIMPF, mais vous pouvez générer directement un fichier CSV en utilisant SQL, voici un petit tutoriel pour vous aider :
Vous devrez utiliser les procédures QSYS2.IFS_WRITE*
https://www.ibm.com/docs/en/i/7.4?topic=is-ifs-write-ifs-write-binary-ifs-write-utf8-procedures
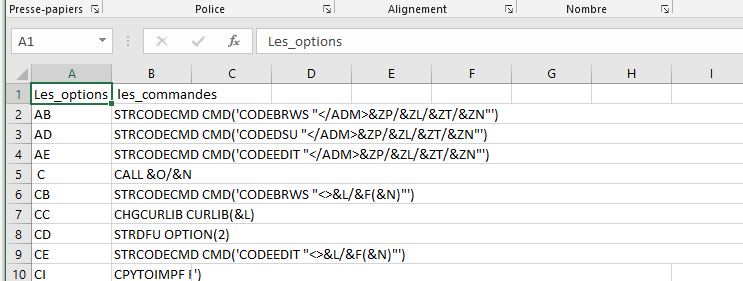
Voici un exemple qui comporte la génération du fichier, l’ajout d’un entête et la génération des listes de détail. Nous avons choisi de faire sans délimiteur et avec « ; » comme séparateur. Le fichier obtenu est directement lisible par Excel.
Si vous voulez un délimiteur voici une variante sur les select avec » comme délimiteur
Pour les entêtes de ligne :
LINE => ‘ »Les_options » ; « Les_commandes »‘)
Pour les lignes de détail, on enlève les blancs :
select ‘ »‘ concat trim(option) concat ‘ » ; « ‘ concat trim(command) concat ‘ »‘ as option_txt from qgpl.qauoopt
Dans cet exemple, on a utilisé la procédure QSYS2.IFS_WRITE_UTF8 pour générer le fichier directement en UNICODE et éviter les problèmes de CCSID, c’est le sens de l’histoire …
Nous n’avons pas précisé de répertoire. Le fichier est créé dans le répertoire par défaut de l’utilisateur, en principe /home/<user>
.
Conclusion :
C’est une solution simple et efficace qui permet de générer un fichier sans passer par un fichier intermédiaire en DB2.
Si vos zones sont numériques vous devrez les convertir par la fonction CHAR()
Merci Nath pour ton aide.
Il est difficile de déboguer un watcher parce qu’on ne maitrise pas son lancement.
Voici une méthode en utilisant RDI, qui va vous permet de le faire :
WRKWCH WCH(*ALL) :
Le message d’affiche :
Pour tester, on peut simuler un traitement qui va planter. Dans notre cas, on fait un call d’un programme qui n’existe pas, et donc ça va faire un plantage dans QSYSOPR.
SBMJOB CMD(CALL PGM(GAIA/ERREURA))
JOB(ERREURA)
JOBQ(QSYSNOMAX)
Une fois le programme a été lancé, sur RDI s’affichera le message suivant :
Cliquer sur « Afficher *LISTING »
Pour avancer d’un pas on peut utiliser la touche F5 ou en cliquant sur la flèche :
Pour afficher les valeurs des variables il suffit de passer la souris sur le nom de la variable :
Conclusion : c’est une solution simple pour déboguer un watcher ou un programme dont vous ne maitrisez pas le lancement.
Le programme doit être compilé avec le source.
Vous devrez avoir le droit pour faire ce type d’opération. Soit au niveau de profil, soit par les fonctions usages.