Vous voulez savoir le droit qu’un utilisateur aura quand il tentera d’accéder à un fichier IFS
Voici un script avec les requêtes qui vous aidera à déterminer le droit que vous obtiendrez.
Vous aurez 8 étapes possibles , et il s’arrêtera à la première correspondance.
--
-- Voici une liste de commande SQL pour trouver le droit d'un utilisateur
-- Sur un fichier IFS
-- ici l'utilisateur PLB
-- tente d'accéder au fichier
--/home/plb/Controle_demarrage_SBS.csv
-- 1 si user *ALLOBJ
-- Si oui tous les droits
--
SELECT SPECIAL_AUTHORITIES,
           FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = 'PLB';
--
-- 2 si user sur l'objet
--
SELECT *
    FROM TABLE (
            QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
        )
    WHERE AUTHORIZATION_NAME = 'PLB';
--
-- 3 si utilisateur dans liste d'autorisations
--
SELECT *
    FROM QSYS2.AUTHORIZATION_LIST_USER_INFO
    WHERE AUTHORIZATION_NAME = 'PLB'
          AND AUTHORIZATION_LISt = (SELECT AUTHORIZATION_LIST
                  FROM TABLE (
                          QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
                      )
                  WHERE AUTHORIZATION_NAME <> '*PUBLIC');
--
-- 4 si groupe all obj
-- Si oui tous les droits
--
  SELECT
       SPECIAL_AUTHORITIES
           FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = ( SELECT GROUP_PROFILE_NAME
    FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = 'PLB');
--
-- 5 si groupe sur l'objet
--
  SELECT * FROM  TABLE(QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv'))
  where AUTHORIZATION_NAME =
    ( SELECT GROUP_PROFILE_NAME
    FROM qsys2.user_info
    WHERE AUTHORIZATION_NAME = 'PLB');
--
--6 Si groupe dans la liste d'autorisation
--
SELECT *
    FROM QSYS2.AUTHORIZATION_LIST_USER_INFO
    WHERE AUTHORIZATION_NAME = (SELECT GROUP_PROFILE_NAME
                  FROM qsys2.user_info
                  WHERE AUTHORIZATION_NAME = 'PLB')
          AND AUTHORIZATION_LIST = (SELECT AUTHORIZATION_LIST
                  FROM TABLE (
                          QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
                      )
                  WHERE AUTHORIZATION_NAME <> '*PUBLIC');
--
--7 Si public
--
SELECT *
    FROM TABLE (
            QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
        )
    WHERE AUTHORIZATION_NAME = '*PUBLIC'
          AND DATA_AUTHORITY <> '*AUTL';
--
--8 Si public reporté sur la liste d'autorisation
--
SELECT *
    FROM QSYS2.AUTHORIZATION_LIST_USER_INFO
    WHERE AUTHORIZATION_NAME = '*PUBLIC'
          AND AUTHORIZATION_LISt = (SELECT AUTHORIZATION_LIST
                  FROM TABLE (
                         QSYS2.IFS_OBJECT_PRIVILEGES('/home/plb/Controle_demarrage_SBS.csv')
                      )
                  WHERE AUTHORIZATION_NAME <> '*PUBLIC');
Remarque :
Ce mécanisme peut être complété par des groupe additionnels , les droits proposés devenant complétifs (‘Ajouter au droit existant’)
Il est conseillé de les utiliser modérément , on peut avoir un système de droit assez efficace juste avec le mécanisme historique
Dans l’IFS l’adoption de droit ne s’applique pas, mais dans vos sript sh vous pouvez utiliser la notion de SETUID
Nous lançons une initiative dédiée à l’Open Source sur IBM i avec une ambition simple et modeste :
Ouvrir, partager et moderniser l’écosystème.
Trop souvent perçu comme un monde fermé, IBM i possède pourtant une richesse technique exceptionnelle. Avec l’Open Source, nous voulons favoriser l’innovation, encourager les échanges entre équipes, accélérer la modernisation des applications et rendre les outils accessibles à tous.
Cette initiative proposera des outils concrets (RPG, SQL, CLLE, APIs), des frameworks prêts à l’emploi, des exemples industrialisables et des bonnes pratiques terrain.
Que vous soyez développeur, architecte ou administrateur IBM i, vous êtes les bienvenus pour contribuer, tester et améliorer ces projets.
Ensemble, faisons évoluer IBM i vers un modèle plus ouvert, collaboratif et moderne.
Pour commencer nous décidons de mettre open source quelques produits ici sur notre Github :
https://github.com/Gaia-Mini-Systemes
Le premier produit s’appelle GDDS il permet de conserver vos options de compile dans vos DSPF ou PRTF
Les sources
https://github.com/Gaia-Mini-Systemes/GDDS
Le objets compilés en V7R4
https://github.com/Gaia-Mini-Systemes/GDDS/releases/tag/GGDS_V1.0
Remarques
N’oubliez pas « Ensemble on est plus fort «
Bien sur nos produits sont BOB compatible
La semaine dernière, à Lyon, lors du congrès Common Europe 2026, nous avons parlé modernisation, APIs, IA… et futur de l’IBM i.
Mais au détour des conversations, difficile d’oublier une évidence :
une partie de notre ADN technologique est née ici même, à Lyon.
Et si les développeurs RPG d’aujourd’hui partageaient, sans toujours le savoir, un héritage direct avec les canuts et les métiers Jacquard ?
Au début du XIXe siècle, Lyon est la capitale mondiale de la soie. Les métiers à tisser sont complexes, coûteux et surtout… difficiles à piloter.
En 1801, Joseph Marie Jacquard introduit une innovation majeure : un métier à tisser contrôlé par des cartes perforées.
Chaque carte représente une ligne du motif à tisser. Les trous dictent mécaniquement quelles aiguilles doivent être activées.
C’est simple, robuste, et surtout :
Autrement dit : le premier système programmable industriel de l’histoire.
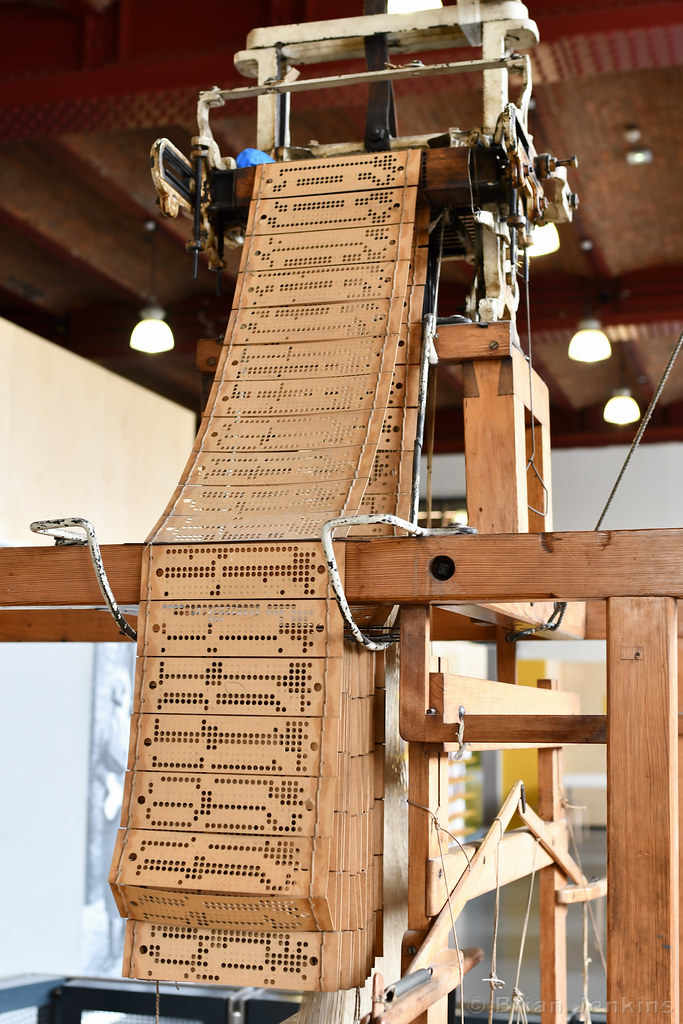
Le métier Jacquard n’a pas été immédiatement accepté. Les canuts voyaient cette innovation comme une menace pour leur savoir-faire… et certains métiers ont même été détruits. C’est finalement Napoléon Bonaparte qui a soutenu Jacquard et officialisé l’usage de sa machine.
On pourrait presque dire que l’histoire de la “programmation” a démarré avec :
Un schéma… encore très actuel ?
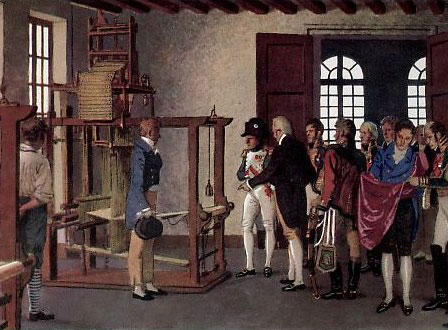
Le principe est fondamental :
L’information n’est plus dans la machine, elle est dans un support externe.
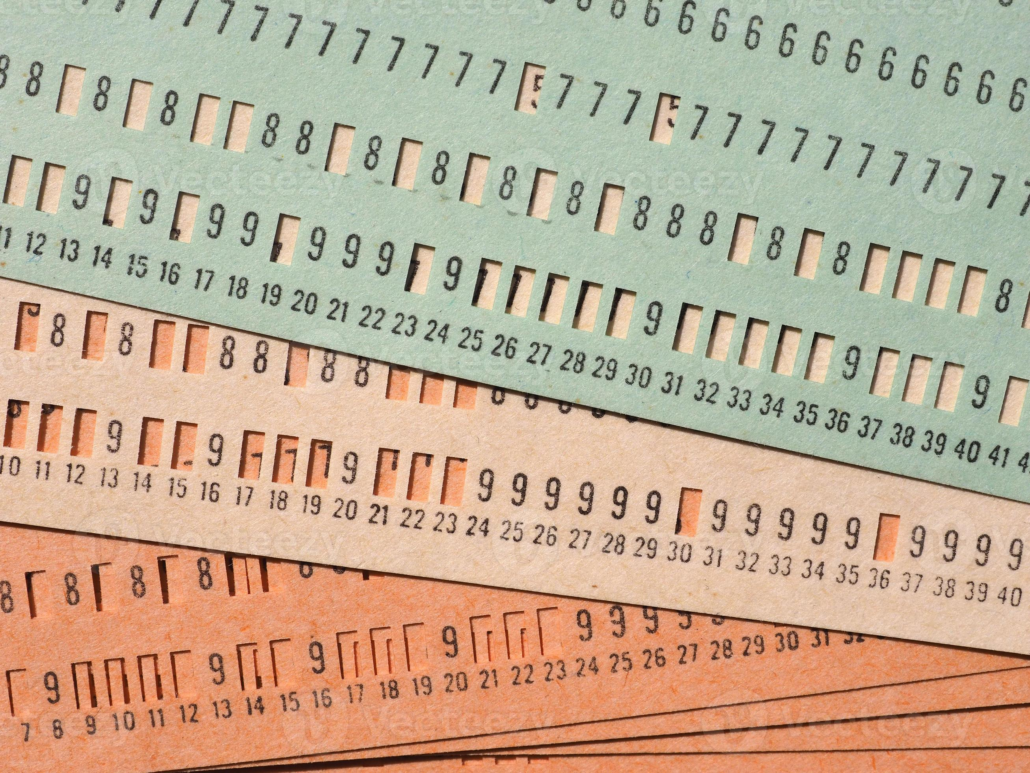
Chaque trou correspond à une instruction binaire :
Ce modèle va traverser les décennies et inspirer directement les premiers systèmes informatiques.
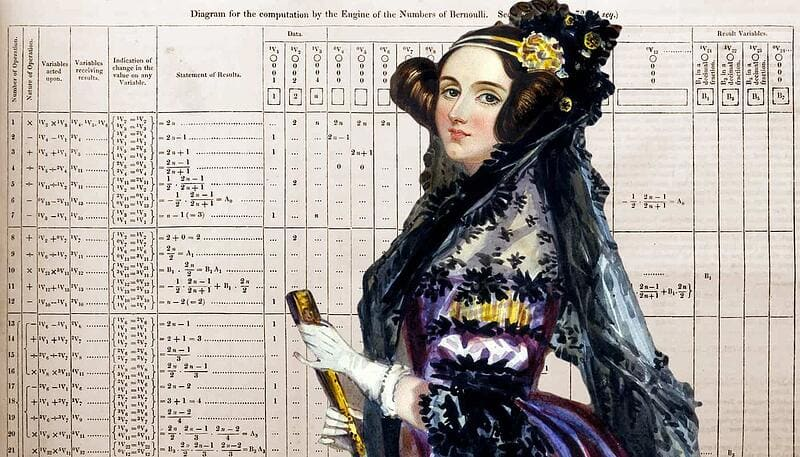
Au XIXe siècle, Charles Babbage conçoit sa “machine analytique”, ancêtre de l’ordinateur.
Son idée ? Utiliser… des cartes perforées inspirées directement du métier Jacquard.
Et Ada Lovelace, souvent considérée comme la première développeuse de l’histoire, va encore plus loin. Elle comprend que la machine pourrait manipuler autre chose que des chiffres.
Elle écrit, en substance :
“La machine pourrait composer de la musique si on lui donnait les règles.”
Autrement dit : la programmation n’était déjà plus une question de calcul, mais de logique et de création.
IBM industrialise massivement l’usage des cartes perforées au XXe siècle.
Le langage RPG, introduit dans les années 1960, est directement conçu pour… les cartes perforées.
Chaque ligne de code correspond à une carte. Chaque colonne a une signification précise.
Exemple :
Ce format n’est pas une contrainte arbitraire, c’est un héritage physique.
Nous n’avons pas changé de paradigme
Nous avons changé de support
Du métier Jacquard à l’IBM i :
À Lyon, pendant le Congrès de Common Europe, difficile de ne pas voir le parallèle :
Les développeurs IBM i sont les héritiers des canuts !
Et au fond, nous faisons le même métier : Transformer des instructions en valeur.
Aujourd’hui vous verrez comment créer un programme capable de convertir un fichier html en PDF depuis votre IBM i à l’aide d’un appel d’API externe.
Rappel sur l’IBMi vous pouvez générer du PDF en utilisant :
Exemple:
wkhtmltopdf (outil de conversion) qui n’est en fait plus du tout maintenu.
On va donc présenter une autre solution qui se base sur les API
Nous avons choisi l’API qui s’appelle PDFSPARK.
Cette solution vous permet de tester notre outil, vous avez jusqu’à 20 requêtes/minute sans clé alors que la plupart des autres API demandent une inscription et proposent environ que 15 requêtes/jour avec un forfait gratuit.
Normalement l’API reçoit une page en ligne en html puis la convertie, mais ici on voulait un .html depuis l’IFS donc j’ai demandé à l’IA (claude) de me faire juste un mini programme pour l’utiliser avec un fichier local et il m’a donné ça :
#!/QOpenSys/usr/bin/bash

export PATH=/QOpenSys/pkgs/bin:/QOpenSys/usr/bin:/usr/bin:$PATH

HTML_FILE=$(echo -n "$1" | tr -d ' ')
PDF_FILE="${HTML_FILE%.html}.pdf"

if [ ! -f "$HTML_FILE" ]; then
    echo "ERROR: HTML file not found"
    exit 1
fi

HTML_CONTENT=$(cat "$HTML_FILE" | jq -Rs .)

curl -s -X POST "https://pdfspark.dev/api/v1/pdf/from-html" \
  -H "Content-Type: application/json" \
  -d "{\"html\": $HTML_CONTENT, \"options\": {\"format\": \"A4\"}}" \
  -o "$PDF_FILE"

echo "DONE : $PDF_FILE"
echo "Your file is located in : $HTML_FILE"jq -Rs)Puis il y a le programme CL qui appelle le .sh depuis 5250 :
PGM PARM(&FILE)

/* début de la construction de la commande bash */
DCL  VAR(&NULL)     TYPE(*CHAR) LEN(1)   VALUE(X'00')

DCL  VAR(&BASH)     TYPE(*CHAR) LEN(100) +
     VALUE('/QOpenSys/usr/bin/bash')

DCL  VAR(&CONVERT)  TYPE(*CHAR) LEN(100) +
     VALUE('/chemin/vers/votre/fichier/html2pdf.sh')
/* fin de la construction de la commande bash */

/* Création de la variable FILE pour rentrer en paramètre
le chemin vers le fichier à convertir depuis 5250 */
DCL  VAR(&FILE)     TYPE(*CHAR) LEN(256)
DCL  VAR(&FILETRIM) TYPE(*CHAR) LEN(100)

               /* concaténation des variables
               pour former la commande bash final */
                CHGVAR VAR(&FILETRIM) VALUE(&FILE)
                CHGVAR VAR(&BASH)     VALUE(&BASH     *TCAT &NULL)
                CHGVAR VAR(&CONVERT)  VALUE(&CONVERT  *TCAT &NULL)
                CHGVAR VAR(&FILETRIM) VALUE(&FILETRIM *TCAT &NULL)

                /*Appel de QP2SHELL pour l'exécution de la commande*/
                CALL PGM(QP2SHELL) PARM(&BASH &CONVERT &FILETRIM)

ENDIT:
ENDPGM
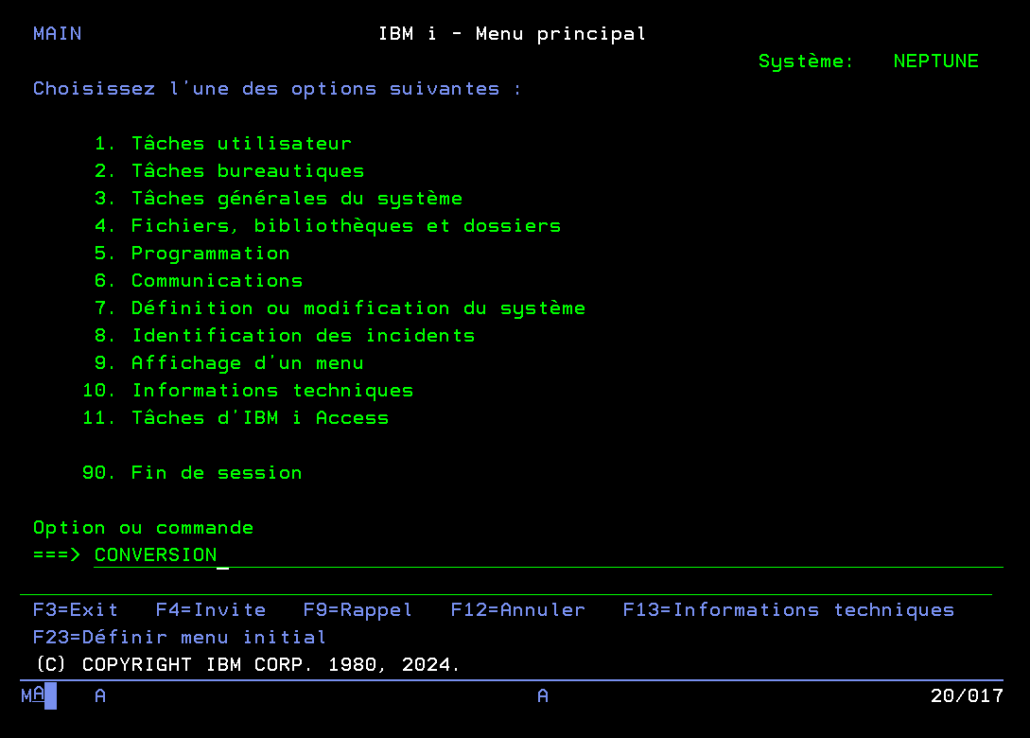
Après compilation et ajout de la librairie, il suffit d’appeler ce programme via l’interface 5250 avec en paramètre le chemin vers le fichier .html que vous voulez convertir en PDF :
==>CALL CONVERSION PARM('/chemin/vers/fichier.html')
Pour l’instant, le nouveau fichier .PDF sera enregistré au même endroit que le .html
vous pouvez créer une commande à appeler depuis 5250 en créant un fichier CONVERSION.CMD comme ceci :
             CMD        PROMPT('Conversion html vers pdf')
             PARM       KWD(FICHIER) TYPE(*CHAR) LEN(256) MIN(1) +
                          PROMPT('Fichier à convertir')
puis la compiler.
Vous pourrez appeler votre programme de conversion depuis 5250 juste avec la commande : conversion puis en appuyant sur F4, tomber sur cet écran qui vous permettra de renseigner (entre simple quote ‘ ) le chemin vers le fichier à convertir (également utilisable en batch):
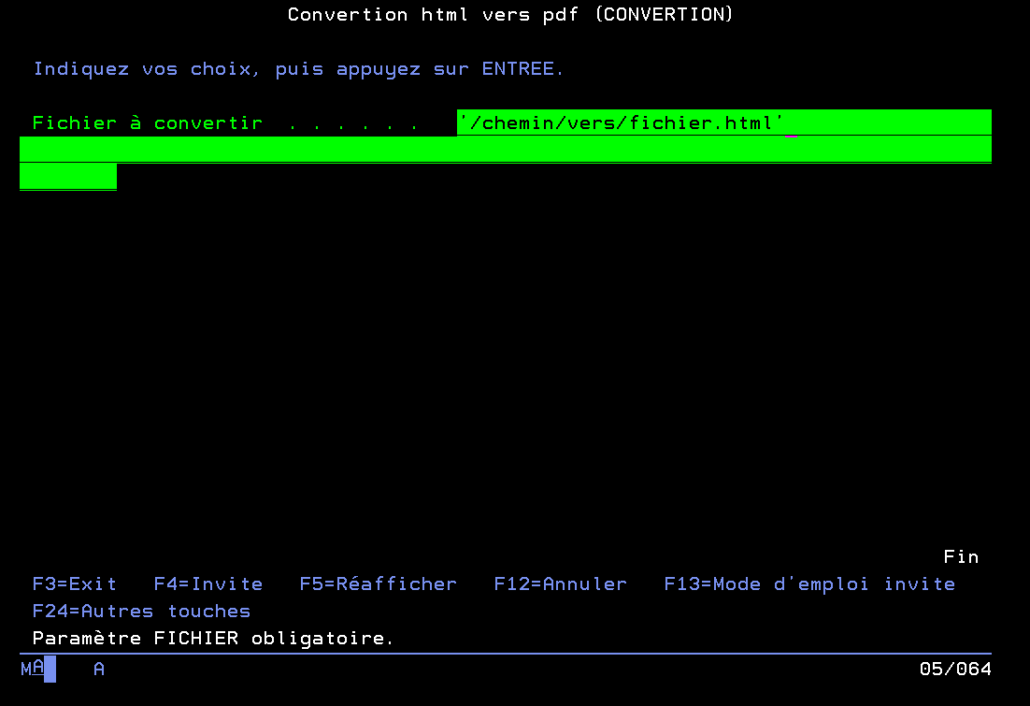
Votre IBMi devra sortir vers l’URL https://pdfspark.dev sur le port 443 , ou vers le provider que vous aurez choisi
Vous pourrez faire des PDF plus évolués que par Transformer, et il est assez facile de générer du HTML.
Vous devrez choisir votre partenaire surtout si vous voulez traiter des données confidentielles
Ici nous avons choisi de faire du CURL , mais vous pouvez utiliser si vous le préférez un programme SQLRPGLE
Vous pouvez bien sur améliorer ce code à votre guise.
Le Model Context Protocol (MCP) est un protocole ouvert et standardisé qui permet aux intelligences artificielles (comme Claude, ChatGPT, ou autres grands modèles de langage) de se connecter facilement à des outils, services et sources de données externes. C’est un peu comme l’USB-C des applications IA : au lieu d’avoir un câble différent pour chaque appareil, tu as un seul connecteur universel qui fonctionne avec tout.
Sans MCP, chaque outil (GitHub, base de données, email, API) avait sa propre façon de se connecter, ce qui obligeait les développeurs à créer des intégrations personnalisées pour chaque combinaison. Avec le MCP, tout le monde utilise la même méthode standard, ce qui rend les connexions beaucoup plus simples et universelles.
Le MCP permet aux IA de sortir de leurs données d’entraînement et d’accéder à des informations en temps réel. Mais surtout, il leur permet d’agir dans le monde réel. Par exemple, tu peux demander à ton IA dans VS Code de lire un fichier source, puis d’écrire automatiquement un résumé dans ton outil de prise de notes comme Notion. D’autres actions possibles : envoyer un email, consulter GitHub, modifier un fichier, créer un événement dans l’agenda, etc. C’est ce qui rend possible l’IA agentique : des programmes intelligents capables de poursuivre des objectifs et d’entreprendre des actions de manière autonome, sans que l’humain ait à copier-coller ou basculer manuellement entre ses outils.
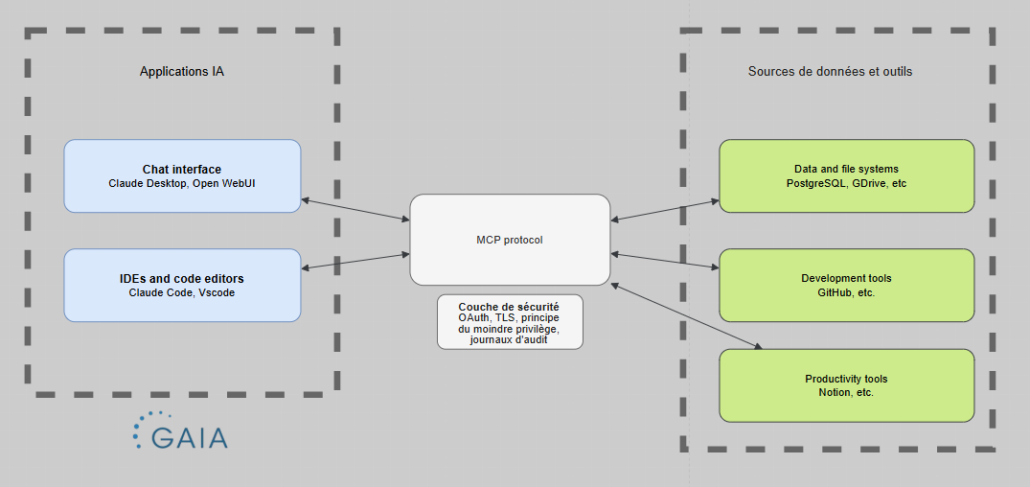
Pour rappel, le protocole MCP joue un rôle essentiel puisqu’il facilite les échanges entre les IA, les applications et les outils utilisés en entreprise. Il permet de connecter plus simplement différents systèmes tout en améliorant la circulation et l’exploitation des données.
Selon les différents rôles dans une entreprise, le MCP apporte plusieurs avantages :
Équipes techniques et développeurs : il simplifie les intégrations, réduit la complexité du développement et accélère la mise en place de nouveaux outils.
Managers et responsables métiers : il améliore l’automatisation, la circulation des informations et l’efficacité des processus internes.
Pour les responsables métiers et managers : ilaméliore la circulation des informations et facilite l’automatisation de certaines tâches. Il aide les managers à gagner du temps, à mieux suivre les activités et à prendre des décisions plus efficacement grâce à un accès simplifié aux données.
En résumé les MCP accompagne la modernisation des entreprises en favorisant des architectures plus connectées, flexibles et évolutives.
Le MCP supporte OAuth pour l’authentification et recommande TLS pour le chiffrement des échanges.deux mécanismes que tu dois explicitement configurer, ils ne sont pas actifs par défaut
Le modèle Zero Trust : « ne jamais faire confiance au réseau, même interne ».
Accorder aux serveurs MCP uniquement les droits strictement nécessaires à leur fonctionnement, conformément au principe du moindre privilège, afin de limiter les risques liés aux erreurs, attaques ou accès non autorisés.
Contrôler régulièrement les accès et permissions attribués à chaque serveur pour éviter toute autorisation excessive ou inutile.
Vérifier et comprendre précisément les accès accordés lors de la mise en place d’une connexion MCP.
Utiliser exclusivement des serveurs MCP fiables et de confiance.
Human-in-the-loop : toujours exiger une confirmation manuelle avant les actions critiques (suppression, déploiement, envoi)
Sandboxing : isoler les serveurs MCP dans des containers Docker pour limiter la portée d’une compromission
Rotation des secrets : ne jamais hardcoder de clés API dans la config MCP.
20 avril 2026. Cette version apporte desévolutions sur l’éxecution de script SQL !
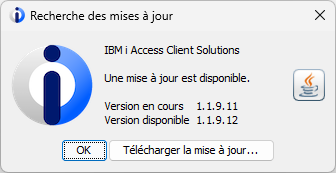
Pour mettre à jour la version disponible sur IBM i :
Nouvelle option :
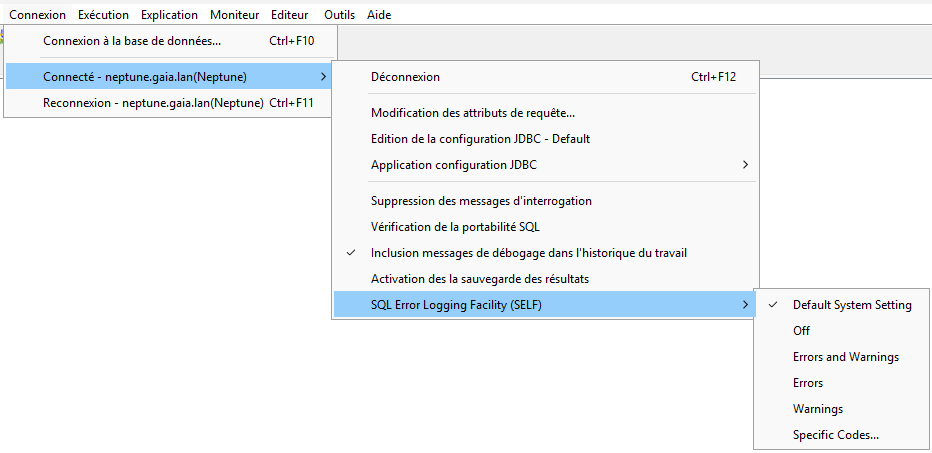
Permet le support de l’outil SELF (SQL Error Logging Facility). Cf SQL Error Logging Facility (SELF) – IBM Documentation
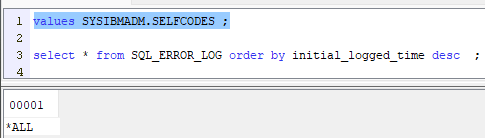
Concrètement, cela modifie la liste des erreurs qui sont tracées dans la vue SQL_ERROR_LOG. Cette liste est stockée dans la variable globale SYSIBMADM.SELFCODES, avec quelques valeurs spéciales (*ALL, *ERROR, *WARN, *NONE).
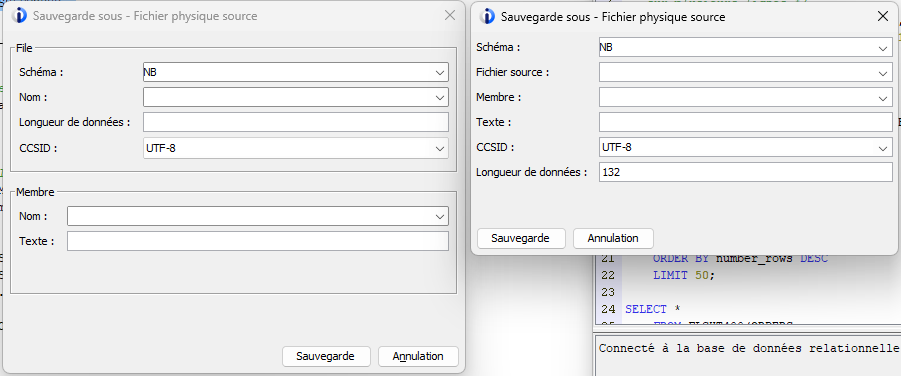
Les caractères LF (x’25’) ne sont plus insérés en fin de ligne dans le cas d’une sauvegarde en fichier source :
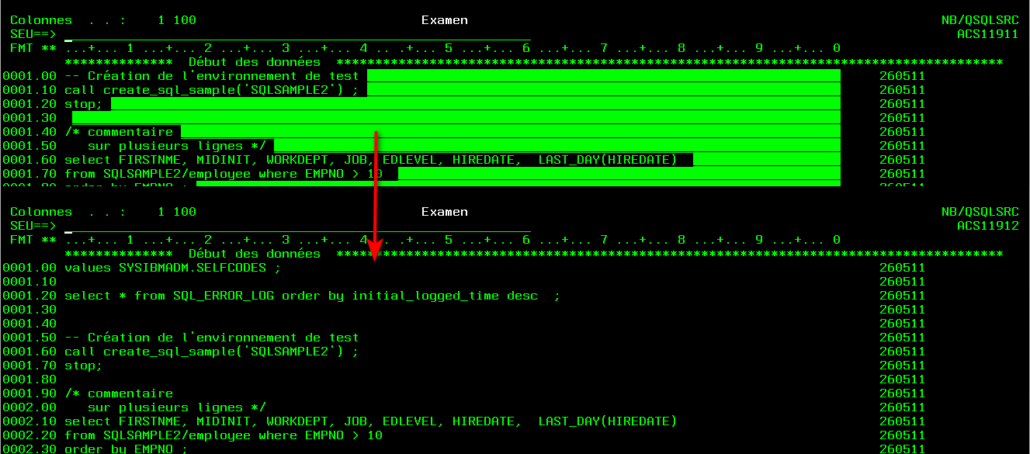
Il n’y pas d’impact à l’éxecution (RUNSQLSTM), mais plus de confort !
Lors de l’enregistrement, au lieu de tronquer les lignes, un message permet d’avertir :
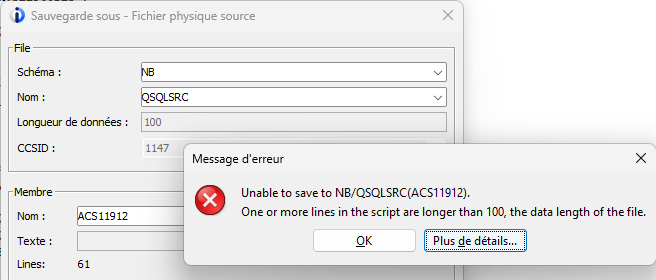
13 nouveaux exemples pour les services SQL :
Pour connaitre le type d’un fichier, vous pouvez vous baser sur le type du Fichier .PDF, .JPG, etc …
Ou vous baser sur le nombre magique , ou signature binaire soit les 4 premiers octets en Hexa
SELECT HEX(SUBSTR(LINE, 1, 4)) AS SIGNATURE
FROM TABLE(QSYS2.IFS_READ_BINARY(‘/home/test.pdf’))
FETCH FIRST 1 ROW ONLY;
Voici un exemple sur 4 fichiers que vous pouvez trouver sur votre partition
SELECT CASE
         WHEN HEX(SUBSTR(LINE,1,4)) = '25504446'
         THEN 'PDF'
         WHEN HEX(SUBSTR(LINE,1,4)) = '89504E47'
         THEN 'PNG'
         WHEN HEX(SUBSTR(LINE,1,4)) = 'FFD8FFE0'
         THEN 'JPG'
         WHEN HEX(SUBSTR(LINE,1,4)) = '504B0304'
         THEN 'ZIP'
         ELSE 'Autre' // inconnu
       END AS TYPE
FROM TABLE(QSYS2.IFS_READ_BINARY('/home/vert.jpg'))
FETCH FIRST 1 ROW ONLY;
Résultat :
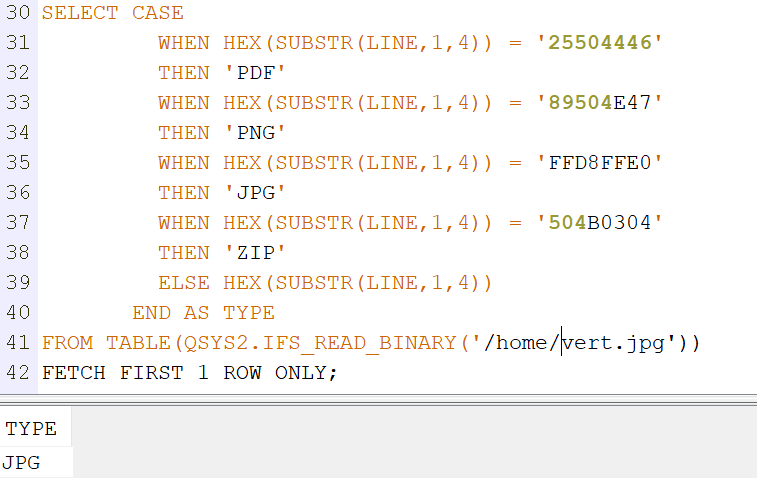
Conclusion :
C’est simple, et efficace, il y a sans doute d’autres manières de faire
Vous avez des spools que vous ne voyez pas et vous ne pouvez pas agir dessus
==>WRKOUTQ
en Face de votre Outq vous avez 918 et quand quand vous regarder dans l’outq vous en avez que 37 par exemple
que faire
Vous regardez par SQL, vous les voyez tous
SELECT
OUTPUT_QUEUE_NAME, SPOOLED_FILE_NAME, USER_DATA, JOB_NAME, FILE_NUMBER
FROM QSYS2.OUTPUT_QUEUE_ENTRIES
WHERE OUTPUT_QUEUE_NAME = ‘votre outq’;
Même par sql vous ne pouvez pas les effacer , c’est un probléme de spool fantômes , souvent le système n’a pas pu les écrire probléme d’espace disque par exemple, que faire ?
==>STRSPLRCL OUTQ(votre bib/votre outq) vous pouvez indiquer *all/*all
vous aurez ce message dans QSYSOPR
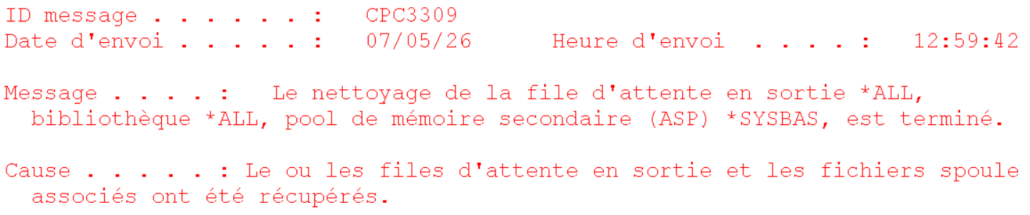
Derrière vous pouvez contrôler tout est redevenu normal cohérent entre la vue et le wrkoutq
Pour en savoir plus
https://www.ibm.com/support/pages/node/643567
un petit rappel, il existe depuis quelque temps un mini ETL qui permet de mettre en place un suivi des codes d’audit pour avoir des statistiques et même un visuel dans Navigator for i
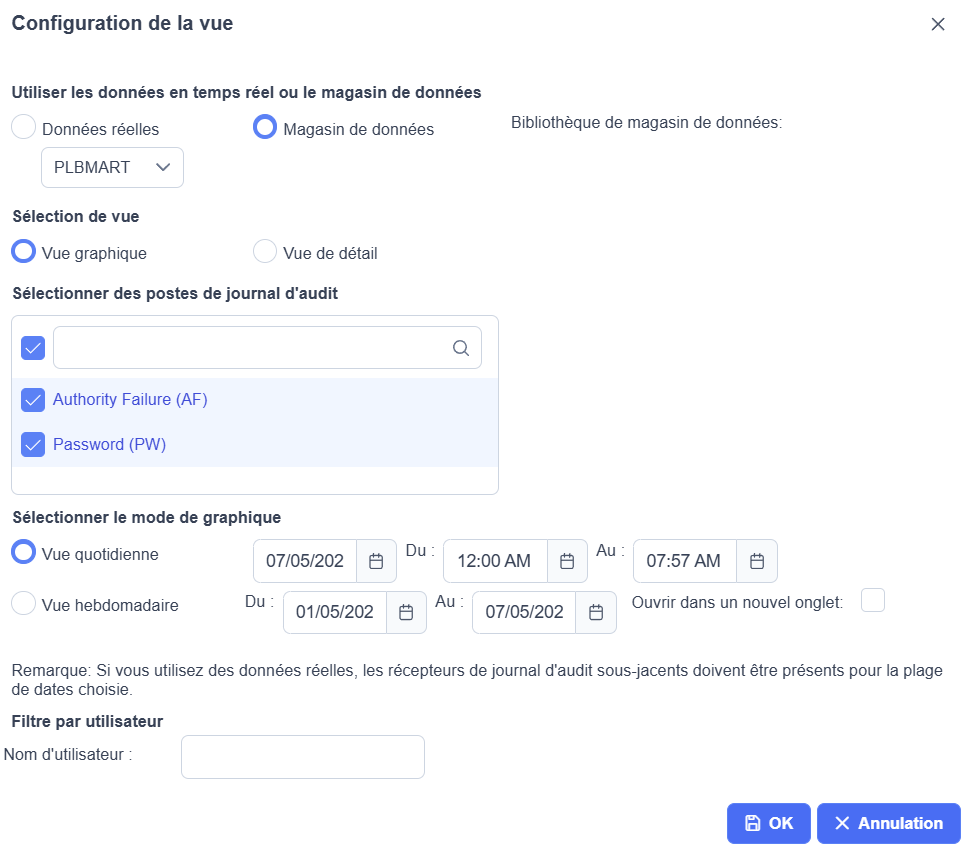
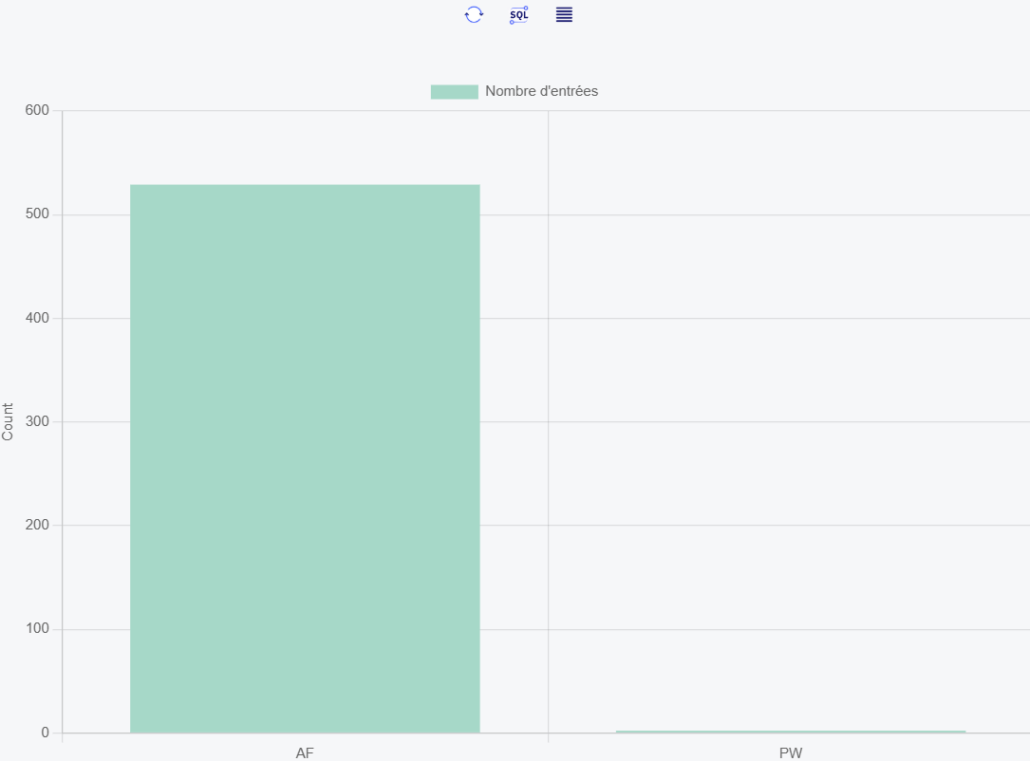
Vous voulez créer un datamart sur plusieurs code exemple PW et AF
et avoir un rafraichissement régulier sur la journée
Vous devez créer vos datamarts avant de commencer
En SQL
CALL QSYS2.MANAGE_AUDIT_JOURNAL_DATA_MART(
JOURNAL_ENTRY_TYPE => ‘Votre code’,
DATA_MART_LIBRARY => ‘Votre bib’,
STARTING_TIMESTAMP => CURRENT DATE – 30 DAYS,
ENDING_TIMESTAMP => CURRENT TIMESTAMP,
DATA_MART_ACTION => ‘CREATE’
);
ou dans l’interface Navigator for i
Journal d’audit
Gérer magasin de donnée
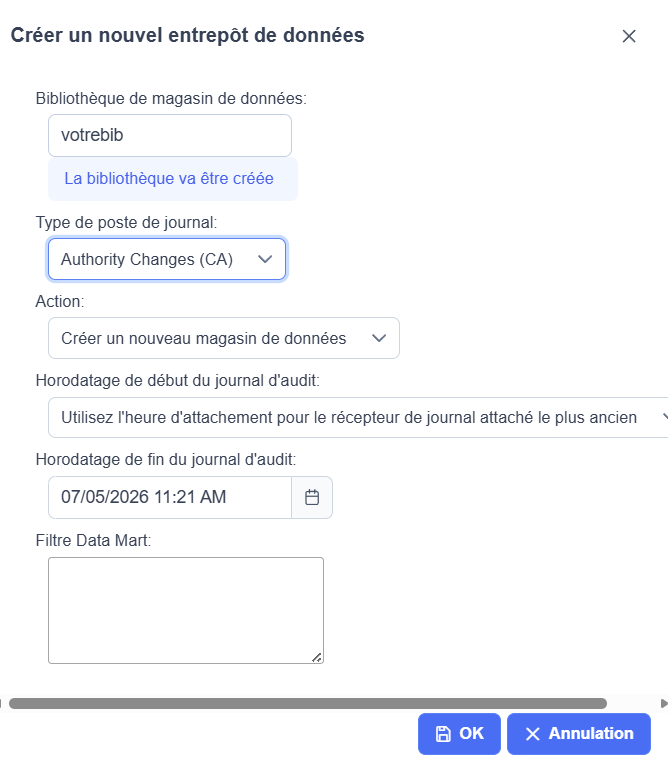
Ca va créer des fichiers dans la bibliothèque choisie
AUDIT_JOURNAL_XX nom SQL
AJ_XX en nom systéme
Vous pouvez les interroger par SQL
exemple:
SELECT
ENTRY_TIMESTAMP,
USER_PROFILE_NAME,
OBJECT_NAME
FROM votrebib.AUDIT_JOURNAL_DO
ORDER BY ENTRY_TIMESTAMP DESC;
Nous allons donc créer un fichier de paramétrage qui contiendra les informations de votre datamart code, bibliothèque, type de rafraichissement , et durée de rétention
Création de la table
CREATE TABLE votrebib/PARMART (
CODE_SUIVI CHAR ( 2) NOT NULL WITH DEFAULT,
BIBLIO CHAR ( 10) NOT NULL WITH DEFAULT,
MISEAJOUR CHAR (10) NOT NULL WITH DEFAULT
duree CHAR ( 03) NOT NULL WITH DEFAULT )
Exemple insertion data dans cette table
INSERT INTO GDATA/PARMART VALUES(‘AF’, ‘PLBMART’, ‘*CONTINUE’, ‘030’)
Nous allons créer un programme AUDITREF
             PGM        PARM(&TIMa &timlim)
/*--------------------------------------------------------*/
/* Ce programme sert de robot pour rafraichir un datamart */
/* exemple toutes les 2 heures, 120 minutes               */
/*--------------------------------------------------------*/
dcl &tima  *char 3  /* Fréquence de rafraichissement en minutes */
dcl &timlim *char 6 /* Heure d'arret du robot                   */
/* Fichier de paramétrage des datamart à rafraichir */
             DCLF       FILE(PARMART)
/* Variable préformatée pour service sql            */
             DCL        VAR(&SQL) TYPE(*CHAR) LEN(512) VALUE('CALL +
                          QSYS2.MANAGE_AUDIT_JOURNAL_DATA_MART(JOURNA+
                          L_ENTRY_TYPE => ''XX'', +
                          DATA_MART_LIBRARY  => ''0123456789'', +
                          STARTING_TIMESTAMP => ''0123456789'', +
                          ENDING_TIMESTAMP   => CURRENT TIMESTAMP, +
                          DATA_MART_ACTION   => ''ADD'')')
dcl &finfichier *lgl
dcl &timsys *char 6 /* Heure système                            */
dcl &timn  *dec  3  /* conversion numérique                     */
/* Boucle de lecture  */
chgvar &timn &tima
boucle:
             DOUNTIL    COND(&FINFICHIER)
             rcvf
             MONMSG     MSGID(CPF0864) EXEC(LEAVE)
CHGVAR %sst(&SQL 66   2) VALUE(&code_suivi)
CHGVAR %sst(&SQL 94  10) VALUE(&Biblio)
CHGVAR %sst(&SQL 130 10) VALUE(&miseajour)
   RUNSQL SQL(&SQL) COMMIT(*NONE)
   monmsg sql0000 exec(do)
             SNDUSRMSG  MSG('Raffraichissement impossible pour,' +
                          *BCAT &CODE_SUIVI *BCAT 'dans le +
                          datamart' *BCAT &BIBLIO) MSGTYPE(*INFO)
   enddo
enddo
             SNDPGMMSG  MSGID(CPF9898) MSGF(QCPFMSG) +
                          MSGDTA('Raffraichisement des datamarts +
                          terminé') MSGTYPE(*COMP)
/* on boucle jusqu'a l'heure limite */
rtvsysval qtime &timsys
             IF         COND(&TIMLIM > &TIMSYS) THEN(do)
                  dlyjob &timn
                  GOTO    CMDLBL(BOUCLE)
                  enddo
             SNDPGMMSG  MSGID(CPF9898) MSGF(QCPFMSG) MSGDTA('Robot +
                          de Raffraichisement arrêté') MSGTYPE(*COMP)
endpgm
Voici la commande pour démarrer le robot
ici toute les heures jusqu’à 22 h
Vous pouvez le mettre dans un scheduler
SBMJOB CMD(CALL PGM(VOTREBIB/AUDITREF) PARM((‘060’) (‘220000’)))
JOB(AUDITREF)
JOBQ(QSYSNOMAX)
Vous devrez si vous utilisez le mode continue faire le ménage dans le datamart
Exemple
DELETE FROM PLBMART/AJ_AF WHERE ENTRY_TIMESTAMP < current timestamp – 30 days
voici un programme de ménage qui se basera sur la zone durée du fichier
             PGM
/*--------------------------------------------------------*/
/* Ce programme sert à épurer les datamarts               */
/* qui travaillent *CONTINUE                              */
/*--------------------------------------------------------*/
/* Fichier de paramétrage des datamart à rafraichir */
             DCLF       FILE(PARMART)
/* Variable préformatée pour service sql            */
             DCL        VAR(&SQL) TYPE(*CHAR) LEN(512)
dcl &finfichier *lgl
/* Boucle de lecture  */
             DOUNTIL    COND(&FINFICHIER)
             rcvf
             MONMSG     MSGID(CPF0864) EXEC(LEAVE)
             CHGVAR     VAR(&SQL) VALUE('DELETE FROM' *BCAT &BIBLIO +
                          *TCAT '/' *TCAT 'AJ_' *TCAT &CODE_SUIVI +
                             *BCAT 'WHERE ENTRY_TIMESTAMP < current +
                          timestamp - ' *BCAT &DUREE *BCAT 'days')
             SNDUSRMSG  MSG(&sql ) MSGTYPE(*INFO)
   RUNSQL SQL(&SQL) COMMIT(*NONE)
   monmsg sql0000 exec(do)
             SNDUSRMSG  MSG('épuration impossible pour,' +
                          *BCAT &CODE_SUIVI *BCAT 'dans le +
                          datamart' *BCAT &BIBLIO) MSGTYPE(*INFO)
   enddo
enddo
             SNDPGMMSG  MSGID(CPF9898) MSGF(QCPFMSG) +
                          MSGDTA('Epuration des datamarts +
                          terminé') MSGTYPE(*COMP)
endpgm
Pour automatiser, lancer le une fois par semaine par exemple
vous pouvez le mettre dans un scheduler
EPUREAUD SBMJOB CMD(CALL PGM(EPUREAUD) )
JOB(EPUREAUD)
JOBQ(QSYSNOMAX)
Remarque :
Bien sur votre fichier PARMART devra être en ligne pour vos traitements
Vous pouvez également opter pour des informations consolidées à la journée le type est alors *REFRESH et vous n’avez à gérer le durée de rétention.
vous avez un fichier de suivi de vos datamarts, QSYS2.AUDIT_JOURNAL_DATA_MART_INFO
Exemple :
select
* from QSYS2.AUDIT_JOURNAL_DATA_MART_INFO ;
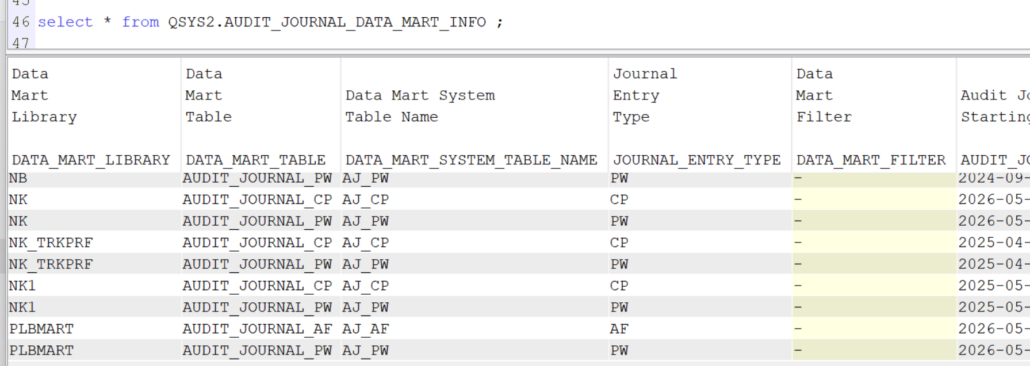
pour suivre votre datamart :
SELECT DATA_MART_TABLE,
BUILD_START,
BUILD_END,
BUILD_JOB
FROM QSYS2.AUDIT_JOURNAL_DATA_MART_INFO
WHERE DATA_MART_LIBRARY = ‘Votre bib’;
Vous pouvez améliorer cette exemple en ajoutant par exemple la création des datamarts dans les CLLE ou en faisant tout en SQL…
Pour en savoir plus sur les datamarts
https://www.ibm.com/docs/en/i/7.4.0?topic=services-manage-audit-journal-data-mart-procedure