Nous en avons récemment fait la promotion via notre page LinkedIn : nous avons commencé à tester l’usage de Bob en interne pour voir ce qu’il a dans le ventre. Nous continuons ce travail tout au long du mois d’août mais déjà, certains retours peuvent être réalisés et notamment à propos d’un élément qui peut aisément passer sous le radar : la commande /init.
Pour celles et ceux qui ont commencé à utiliser Bob, vous aurez constaté qu’IBM a créé une page d’accueil spécifique pour les détenteurs d’une licence payante. C’est assez sympa, IBM y a centralisé des accès vers des présentations rapides d’outils pratiques.
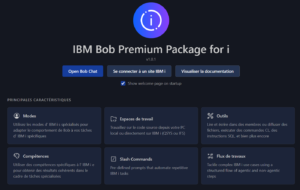
Vous aurez remarqué qu’une des tuiles se nomme « Slash Commands », que l’on peut traduire dans la langue de Molière par « commandes intégrées ». Et étrangement, /init est absente de la liste des commandes intégrées à laquelle cette tuile donne accès. Il m’a fallu lire la documentation en ligne de Bob avec un peu plus d’attention pour trouver trace de son existence.
/initBon, la grammaire est assez transparente, vous l’aurez compris, cette commande a un rôle d’initialisation. Mais initialiser quoi, en fait ?
Eh bien d’initialiser l’utilisation de Bob dans votre projet ! L’idée derrière cette commande est de générer un ensemble de documents, adaptés à l’environnement de travail actuellement ouvert, sur lesquels Bob pourra ensuite s’appuyer pour répondre à vos demandes de manière plus efficaces et moins coûteuse.
Cette partie est assez simple :
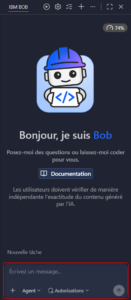
L’exécution de la commande va générer plusieurs documents markdown nommés AGENTS.md.
Cette commande se base sur l’espace de travail actuellement ouvert dans Bob ; typiquement, votre référentiel Git local d’un projet hébergé sur Github / Gitlab / votre IBM i.
Le fait même que la commande crée un dossier ‘.bob’ la rend incompatible avec une vision purement « QSYS ».
Vous pouvez utiliser la notion de surchargées SQL
Une surcharge c’est le fait de pouvoir appeler avec plusieurs prototypages différents, une fonction ou une procédure SQL
Voici un exemple :
soit une fonction qui convertit un integer en char

CREATE OR REPLACE FUNCTION PLB.FORMAT_CODE(P_VAL INTEGER)
RETURNS VARCHAR(10)
LANGUAGE SQL
SPECIFIC FORMAT_CODE_INT
BEGIN
    RETURN CHAR(P_VAL);
END;
soit une fonction même nom qui convertit un char en majuscule
CREATE OR REPLACE FUNCTION PLB.FORMAT_CODE(P_VAL VARCHAR(10))
RETURNS VARCHAR(10)
LANGUAGE SQL
SPECIFIC FORMAT_CODE_CHAR
BEGIN
    RETURN UPPER(TRIM(P_VAL));
END;
— Voici un jeu d’essai pour tester ces fonctions
— Création table de test
CREATE TABLE PLB.TESTSUR (
TESTINT INT NOT NULL WITH DEFAULT,
TESTCHAR VARCHAR ( 10) NOT NULL WITH DEFAULT)
INSERT INTO PLB.TESTSUR VALUES(1964, ‘PIERRE’) ;
INSERT INTO PLB.TESTSUR VALUES(1987, ‘Robert’) ;
— Test
SELECT plb.FORMAT_CODE(TESTINT),
plb.FORMAT_CODE(TESTCHAR)
FROM PLB.TESTSUR;
SQL choisit la fonction en fonction du type de paramètres reçus
Remarque :
il peut être intéressant de savoir si on a des fonctions ou procédures surchargées sur notre partition, notamment en cas de maintenance, cette information est importante.
Voici une petite requête pour analyser tout ca
SELECT   ROUTINE_SCHEMA,
         ROUTINE_NAME,
         COUNT(*)    AS NB_VARIANTES,
         'FONCTION'  AS TYPE_ROUTINE
FROM     QSYS2.SYSFUNCS
WHERE ROUTINE_SCHEMA not LIKE('SYS%')
and ROUTINE_SCHEMA not LIKE('QSYS%')
GROUP BY ROUTINE_SCHEMA,
         ROUTINE_NAME
HAVING   COUNT(*) > 1
UNION
SELECT   ROUTINE_SCHEMA,
         ROUTINE_NAME,
         COUNT(*)    AS NB_VARIANTES,
         'PROCEDURE' AS TYPE_ROUTINE
FROM     QSYS2.SYSPROCS
WHERE ROUTINE_SCHEMA not LIKE('SYS%')
and ROUTINE_SCHEMA not LIKE('QSYS%')
GROUP BY ROUTINE_SCHEMA,
         ROUTINE_NAME
HAVING   COUNT(*) > 1
ORDER BY ROUTINE_SCHEMA,
         ROUTINE_NAME,
         TYPE_ROUTINE;
Vous pouvez facilement l’améliorer en joignant avec la vue SYSPARMS par exemple
Par exemple, vous utilisez SQL Error Logging Facility (SELF).
Vous voulez analyser les erreurs générées
Les erreurs sont stockées dans la vue SQL_ERROR_LOG de QSYS2
Vous avez une zone LOGGED_SQLCODE et une LOGGED_SQLSTATE qui contiennent le SQLCODE et le SQLSTATE de l’erreur
Vous voulez connaitre l’explication sur l’erreur SQL, vous avez des fonctions table SQLCODE_INFO et SQLCODE_STATE qui interprètent ce code
exemple :
SELECT LOGGED_SQLCODE,
STATEMENT_TEXT,
STATEMENT_OPERATION_DETAIL,
PROGRAM_LIBRARY,
PROGRAM_NAME
FROM QSYS2.SQL_ERROR;
Ajouter la Fonction table
SELECT LOGGED_SQLCODE,
(SELECT Message_text
FROM TABLE (
SYSTOOLS.SQLCODE_INFO(LOGGED_SQLCODE)
)) AS SQLCODE_TEXT,
STATEMENT_TEXT,
STATEMENT_OPERATION_DETAIL,
PROGRAM_LIBRARY,
PROGRAM_NAME
FROM QSYS2.SQL_ERROR;
Vous pouvez le faire sur le SQLSTATE ou sur le SQLCODE
Autre exemple, dans une programme RPGLE vous pouvez faire ceci par exemple
W_Text_sql char(512) ;
W_sqlcode like(sqlcode) ;
// traitement des erreurs SQL
if sqlcode <> 0;
w_sqlcode = sqlcode;
exec sql
// calcul du nombre de job à supprimer
SELECT Message_text into :W_Text_sql
FROM TABLE (
SYSTOOLS.SQLCODE_INFO(:w_sqlcode))
;
// Ecriture message dans la log
snd-msg (W_Text_sql) ;
endif ;
Plus d’informations ici
https://www.ibm.com/docs/en/i/7.6.0?topic=services-sqlcode-info-table-function
https://www.ibm.com/docs/en/i/7.6.0?topic=services-sqlstate-info-table
Rappel
il est important de traiter les erreurs SQL sur chaque instruction
Par exemple, vous voulez créer une commande qui suppriment les travaux d’un utilisateur avec des noms dupliqués ce que ne permet pas la Commande ENDJOB nativement.
Vous choisissez de le faire en SQLRPGLE, vous avez la fonction table QSYS2.ACTIVE_JOB_INFO qui va permettre de trouver les travaux à supprimer
Exemple :
Pour savoir le nombre de travaux à supprimer
dcl-s w_cnt int(10);
P_jobn = ‘QHSTB’ ;
P_user = ‘PLB’;
exec sql
SELECT COUNT(*)
INTO :w_cnt
FROM TABLE (
QSYS2.ACTIVE_JOB_INFO(JOB_NAME_FILTER => :p_jobnm)
) A
WHERE A.JOB_USER = :p_user ;
Remarque
Vous pouvez indiquer le nom du job dans le filtre et l’utilisateur dans la clause where de sélection
Maintenant pour agir vous devez utiliser la fonction QCMDEXC
SELECT QCMDEXC(‘ENDJOB JOB(‘ concat trim(A.JOB_NAME) concat ‘) OPTION(*IMMED)’)
FROM TABLE (
QSYS2.ACTIVE_JOB_INFO(JOB_NAME_FILTER => :P_jobn)
) A
WHERE A.JOB_USER = :p_user ;
Cette commande marche dans ACS par exemple, ou ajoutant un create table as dans un RUNSQL ou un RUNSQLSTM;
Le probléme de cette solution en RPGLE est qu’elle va vous obliger à avoir un curseur
soit dans le RPGLE
soit en faisant du Dynamic Compound Statement (Compile de code SQL à la volée)
Voici une astuce qui va permettre d’éviter le curseur
exec sql
SELECT COUNT(*) INTO :w_cnt
FROM TABLE(QSYS2.ACTIVE_JOB_INFO(
JOB_NAME_FILTER => :p_jobnm)) AS A
WHERE A.JOB_USER = :p_user
AND QSYS2.QCMDEXC(
‘ENDJOB JOB(‘ CONCAT TRIM(A.JOB_NAME)
CONCAT ‘) OPTION(*IMMED)’
) = 1;
On va utiliser le QCMDEXC dans la clause where
En effet cette fonction renvoie 1 quand c’est ok
Conclusions :
C’est simple et efficace
Mais attention à la sécurité et l’injection de code par exemple avec une clause where paramétrable qui peut permettre de passer n’importe quelle commande ?
Astuce :
Vous pouvez faire une commande qui lancera votre programme
CMD PROMPT(‘Arrêter plusieurs Travaux’)
PARM KWD(JOBNM) TYPE(*NAME) LEN(10) MIN(1) +
PROMPT(‘Travail’)
PARM KWD(USER) TYPE(*NAME) LEN(10) MIN(1) +
PROMPT(‘Utilisateur’)
Fonction QSYS2.CREATE_DATA_JOURNAL_READER
Pour analyser des journaux la difficulté est de traiter le poste *entry data qui est spécifique à chaque fichier
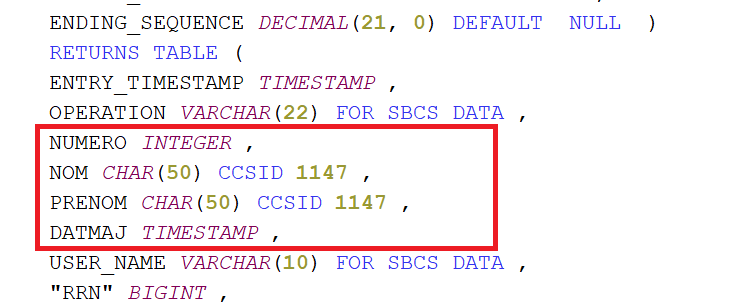
La tr2 de la v7R6 et la tr8 de la v7r5 permet de résoudre cette problématique en créant une fonction spécifique sur un fichier pour analyser les postes de TYPE R
Voici un petit protocole de test
— création d’un schéma
create schema testjrn ;
CREATE TABLE TESTJRN/TESTABLE (
NUMERO INT NOT NULL WITH DEFAULT,
NOM CHAR ( 50) NOT NULL WITH DEFAULT,
PRENOM CHAR ( 50) NOT NULL WITH DEFAULT,
DATMAJ TIMESTAMP NOT NULL WITH DEFAULT) ;
— génération de modifications dans le journal
INSERT INTO TESTJRN/TESTABLE VALUES(1, ‘Berthoin’, ‘Pierre-Louis’,
current timestamp);
INSERT INTO TESTJRN/TESTABLE VALUES(2, ‘Berthoin’, ‘Younes’,
current timestamp) ;
INSERT INTO TESTJRN/TESTABLE VALUES(3, ‘Mbappé’, ‘Kilian’, current
timestamp) ;
INSERT INTO TESTJRN/TESTABLE VALUES(4, ‘Chombier’, ‘Patrice’,
current timestamp) ;
UPDATE TESTJRN/TESTABLE SET PRENOM = ‘Robert’ WHERE NUMERO = 4;
DELETE FROM TESTJRN/TESTABLE WHERE NUMERO =3 :
— génération de la fonction table spécifique à votre fichier
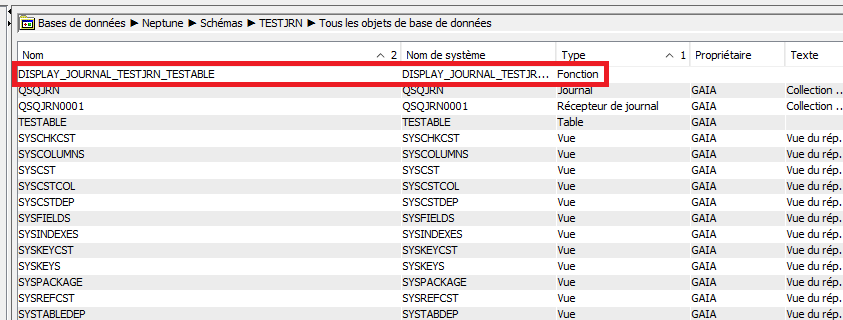
VALUES QSYS2.CREATE_DATA_JOURNAL_READER(LIBRARY_NAME => ‘TESTJRN’,
FILE_NAME => ‘TESTABLE’,
OUTPUT_LIBRARY => ‘TESTJRN’);
— Utilisation de la fonction générée
SELECT * FROM TABLE (TESTJRN.DISPLAY_JOURNAL_TESTJRN_TESTABLE());
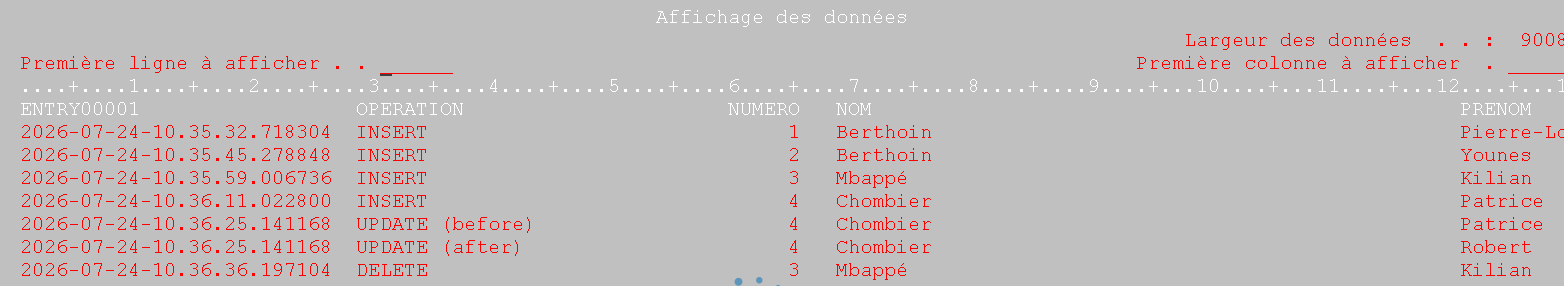
bien sur vous pouvez mettre des filtres sur l’affichage
Les liens à connaitre
https://www.ibm.com/support/pages/qsys2createdatajournalreader
https://www.ibm.com/docs/en/i/7.6.0?topic=function-using-data-journal-reader
Vous avez tous entendu parlé de entendu RPGUNIT
C’est un projet qui a eu plusieurs Vies, il existe même un plugin RDI et une extension vscode
C’est un projet qui permet de faire des tests unitaires sur des fonctions ILE
Il est basé sur les « assertions »
En informatique c’est une vérification intégrée dans le code qui s’assure qu’une condition spécifique est vraie à un moment donné de l’exécution du programme
Exemple :
2+2 ca doit faire 4
https://fr.wikipedia.org/wiki/Assertion
Voici un petit exemple
D’abord vous devez installer une version de la bibliothèque RPGUNIT sur votre systéme, cette bibliothèque contient le Framework qui va permettre de mettre en œuvre vos tests
Vous devrez avoir un programme service et connaitre la fonction à tester
Vous allez créer un programme de service spécifique qui va créer des surcouche à vos fonction
Exemple :
Fonction calcul dans votre application deviendra Fonction test_calcul dans le programme de service RPGUNIT
Votre programme CALCUL ici dans la bibliothèque DEMOUNIT
**free

ctl-opt nomain;

dcl-proc Addition export;

   dcl-pi *n int(10);
      a int(10) const;
      b int(10) const;
   end-pi;

   return a + b;

end-proc;
Génération de votre programme de service
CRTRPGMOD MODULE(DEMOUNIT/CALCUL)
SRCFILE(DEMOUNIT/QRPGLESRC)
CRTSRVPGM SRVPGM(DEMOUNIT/CALCUL)
MODULE(DEMOUNIT/CALCUL)
EXPORT(*ALL)
Vous devrez coder un programme de service RPGUNIT qui ressemblera à ca
Une hypothèse avec un cas vrai et une erreur
**free
ctl-opt nomain;
/include RPGUNIT/QINCLUDE,ASSERT


dcl-pr Addition int(10);
   a int(10);
   b int(10);
end-pr;


dcl-proc testAddition export;

   iEqual(
      5 :
      Addition(2:3)
   );

end-proc;
// Test volontairement en erreur
dcl-proc testErreur export;

   iEqual(
       10 :
       Addition(2:3)
   );
Pour générer votre programme
CRTRPGMOD MODULE(DEMOUNIT/TESTCALC)
SRCFILE(DEMOUNIT/QRPGLESRC)
CRTSRVPGM SRVPGM(DEMOUNIT/TESTCALC)
MODULE(TESTCALC)
BNDSRVPGM(DEMOUNIT/CALCUL RPGUNIT/RUTESTCASE)
EXPORT(*ALL)
ou par RPGUNIT/RUCRTRPG , mais attention au liage ???
Vous devrez ensuite lancer le contrôle par la commande
==>RPGUNIT/RUCALLTST TESTCALC
Vous obtenez un spool RPGUNIT
Exemple :
 *** Tests of TESTCALC ***
 Date        : 2026-07-23 / 15:41:45
 Job         : 935696/PLB/QPADEV002D
 User        : PLB
 iRPGUnit    : v6.0.0.v
 IBM i       : V7R6M0
 Cur. library: PLB
 Library list:   10 RPGUNIT        60 OUTILS
                 20 DEMOUNIT       70 TOOLS
                 30 QGPL
                 40 QTEMP
                 50 EXPLOIT
 TESTERREUR - FAILURE
 Expected 10, but was 5.
   TESTERREUR (TESTCALC->TESTCALC:888)
 Expected:        1 '10'
 Actual:          1 '5'
 -----------------------
 FAILURE. 3 test cases, 2 assertions, 1 failure, 0 error.
ici on a bien validé nos 2 caseq
Les sources et outil de référence se trouvent ici
https://irpgunit.sourceforge.io/
https://github.com/Tools-400/irpgunit
Remarque :
Vous avez pouvez faire des choses plus évoluées et VSCODE vous offre un assistant pour générer le programme RPGUNIT de Test, mais je pense qu’il est important de comprendre ce qu’on fait
Les assertions sont inclues en standard dans la TR2 en V7R6 pour le RPGLE
https://www.ibm.com/support/pages/node/7276258
Site pour les extensions
iRPGUnit Plug-in Update Site RDi 9.6.0.13+
https://tools-400.github.io/irpgunit/update-site/eclipse/rdi8.0
Merci à Florian pour son aide !
On a parfois besoin d’envoyer pour différentes raisons des messages en RPGLE
Voici un tableau comparatif des solutions existantes :
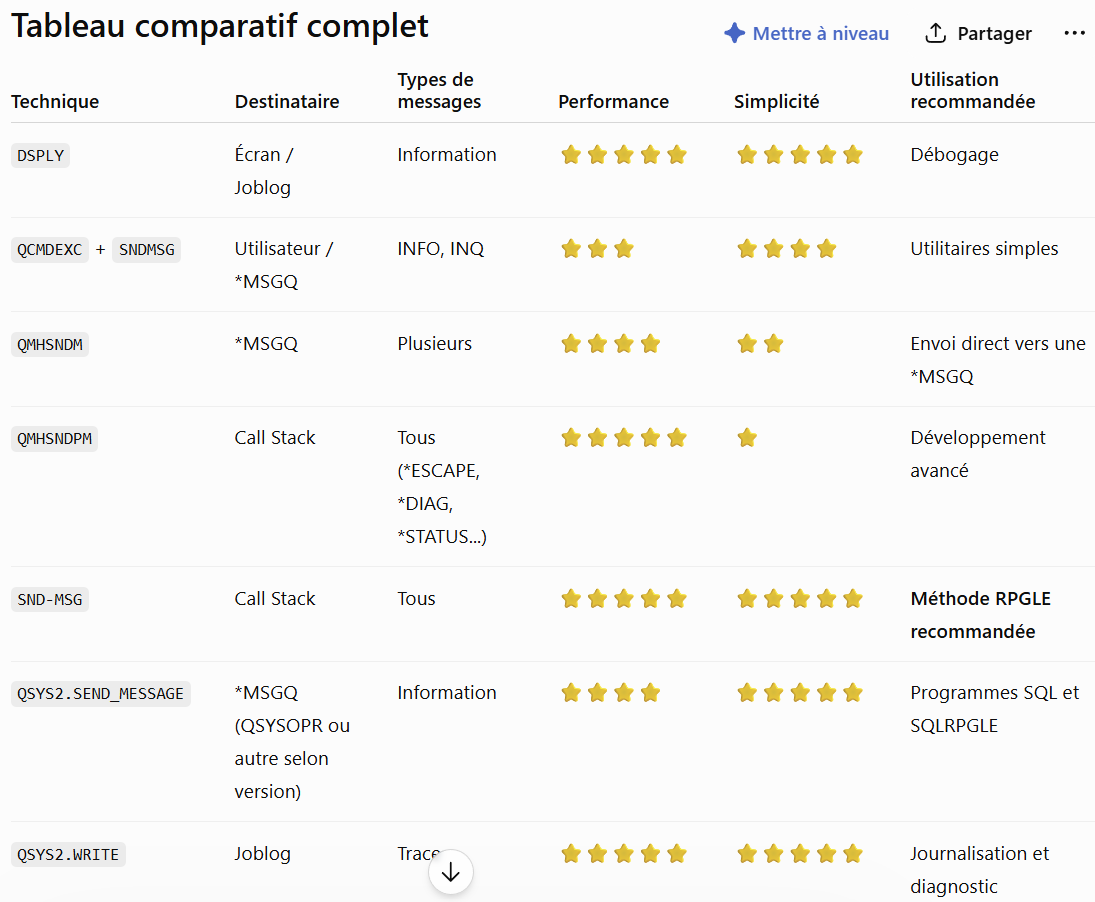
Conclusions
Pour un développement moderne sur IBM i 7.5 ou plus voici nos préconisations :
SND-MSG pour les messages applicatifs en RPGLE (notamment *ESCAPE, *DIAG, *STATUS) , pour du SQLRPGLE il remplace avantageusement le dsply
QSYS2.SEND_MESSAGE lorsqu’on est principalement en SQL ou SQLRPGLE, il permet par exemple de choisir une file de messages
QSYS2.WRITE pour remplacer les DSPLY de débogage par des traces propres dans la joblog
QMHSNDPM pour les développements avancés , par exemple pour échanger vers des files de messages programmes
Remarques
Pour des actions particulières, par exemple refus de trigger, erreur de données dans un cgi, il peut être plus judicieux de créer un fichier de log.
Il devra contenir les informations sur la nature de l’erreur et le contexte d’exécution à minima user, job, date heure, programme
Vous devez ou vous devrez vous conformer à la norme ISO27001 :
Voici quelques points à contrôler qu’un auditeur pourrait vous demander
1) séparation DEV / TEST / PROD
Ils vérifieront que vous avez à minima 3 environnements, 2 machines sont une bonne pratique
2) Git ou gestionnaire de versions
Ils vérifieront que vous avez un versioning de votre code source, aujourd’hui git est incontournable pour réaliser cette opération
3) Revue de code documentée
Ils vérifieront que vous faites des revues de code et que vous avez des actions suite à celle-ci, exemple modernisation du code obsolète entrant en maintenance.
4) Les droits des développeurs
Ils vérifieront par exemple qu’aucun développeur reste avec *ALLOBJ permanent, et qu’il a des droits limités et tracés à les actions en production
5) Données sensibles chiffrées en transit (TLS/HTTPS)
Ils vérifieront qu’aucune données ne circule en claire , mise en œuvre de TLS
6) Contrôle des accès aux objets
Ils vérifieront les droits d’accès aux objets , la bonne pratique est *use sur les programmes *change sur les datas
7) Journalisation et suivi des changements
Ils vérifieront que les modifications effectuées correspondent à une demande documentée et éventuellement un ticket d’incident ou de correctif
8) Procédure de mise en production documentée
Ils vérifieront que vous avez un process de mise en production avec de interlocuteurs différents pour les rôles jusqu’à la mise en production
9) Normes de développement sécurisées
Ils vérifieront que vous avez des normes de développement (nommage , SQL préparé, validation des entrées ou paramètres, gestion des erreurs)
Conclusion :
Tous ces points ne vous garantissent pas de passer un audit confortable, mais ils vous permettront d’avoir des éléments pour engager un dialogue
Pour en savoir plus
Ces derniers jours, j’ai installé un serveur MCP IBM i en m’appuyant sur Service Commander. Une opération qui, sur le papier, semblait relativement simple : installer le serveur MCP, créer le service par service commander pour faciliter l’exploitation.
Pourtant, je me suis retrouvé face à un comportement particulièrement déroutant. Et c’est là que l’utilisation de l’IA (BOB en l’occurrence) s’est révélée extrêmement intéressante.
Le serveur MCP démarrait parfaitement lorsque je lançais cette commande avec le profil MCPSERVER créé pour l’occasion :
sc start ibmi-mcp-server
Mais avec mon profil habituel, j’obtenais systématiquement un message d’erreur, ou alors un message de complétion mais le serveur MCP était inactif.
Le détail intriguant était que le service était pourtant configuré pour soumettre le job sous le profil MCPSERVER :
sbmjob_opts: 'JOBQ(QUSRNOMAX) USER(MCPSERVER)'
En théorie, le profil appelant n’aurait donc pas dû avoir d’importance.
Le premier réflexe est de suspecter :
J’ai commencé à analyser les jobs, les spools, les variables d’environnement et les traces de démarrage.
Rapidement, une chose est apparue : le job était bien soumis sous MCPSERVER, mais l’environnement du processus n’était pas toujours cohérent.
Les premiers logs montraient que lorsque le démarrage était demandé par NB, certaines informations restaient liées à ce profil :
HOME=/home/NB
USER=nb
LOGNAME=nb
alors que le job tournait sous MCPSERVER.
J’ai donc modifié la configuration pour désactiver l’héritage implicite de l’environnement :
environment_is_inheriting_vars: false
et défini explicitement les variables nécessaires.
Le comportement a changé, mais le problème n’était toujours pas totalement résolu.
Pendant plusieurs itérations, j’ai tenté de simplifier la définition du service :
start_cmd: /QOpenSys/pkgs/bin/bash -lc 'exec npx ...'
Curieusement :
J’ai alors déplacé toute la logique de démarrage dans un wrapper (un shell script start-mcp.sh) :
#!/QOpenSys/pkgs/bin/bash
export HOME=/home/MCPSERVER
export USER=MCPSERVER
cd /projet/ibmi-mcp-server
exec npx -y @ibm/ibmi-mcp-server@latest \
     --transport http \
     --tools ./tools
Puis :
start_cmd: /projet/ibmi-mcp-server/start-mcp.sh
Et là, miracle :
La configuration devenait à la fois plus robuste et plus lisible.
Comme si cela ne suffisait pas, les logs contenaient également des messages du type :
Objet introuvable. L'objet est FR_FR.UTF-8.
warning: setlocale: LC_ALL: cannot change locale (ur_PK.UTF-8)
Pourquoi un serveur IBM i situé en France essayait-il d’utiliser une locale pakistanaise ?
Après investigation, j’ai découvert que Service Commander contient la logique suivante :lorsque aucune locale UTF-8 n’est définie dans l’environnement, Service Commander choisit simplement… la dernière locale (par ordre alphabétique) UTF-8 trouvée sur le système.
Sur ma machine, c’était : ur_PK.UTF-8, c’est-à-dire :
D’où le message surprenant.
La solution a finalement consisté à définir explicitement :
export LC_ALL=FR_FR.UTF-8@euro
dans ~/.profile et ~/.bashrc
Depuis, plus aucun avertissement.
Ce que l’IA m’a réellement apporté ?
La partie la plus intéressante de cette aventure n’est pas le problème technique lui-même, j’aurais fini par trouver la solution. Les indices étaient là :
Mais cela m’aurait probablement pris plusieurs heures supplémentaires, que j’aurais réparti sur plusieurs jours.
L’IA n’a pas « résolu le problème à ma place ». Elle n’a pas eu accès à ma machine (je vous rappelle que j’installais le serveur MCP à ce moment là), à mes commandes ou à la documentation interne de mon environnement.
En revanche, elle a joué un rôle extrêmement utile :
En pratique, elle s’est comportée comme un collègue expérimenté assis à côté de moi, capable de relire instantanément chaque log et de suggérer la prochaine étape.
Pas beaucoup sur cette affaire là ! Pas de commande (shell ou IBM i) extravagante, de boucle dans les réponse, d’idée totalement saugrenue.
Attention, plusieurs critères à prendre en compte :
L’apport principal de BOB dans ce type de situation n’est pas le remplacement de l’expertise.
C’est l’accélération du diagnostic.
Mon expertise IBM i m’a permis d’interpréter les résultats, de comprendre les implications et de valider les solutions. L’IA, elle, m’a aidé à parcourir beaucoup plus rapidement l’arbre des hypothèses possibles.
Résultat :
Et, accessoirement, j’ouvrirais une issue sur la gestion des locales par service commander !