Une des fonctionnalités attendues disponible avec la 7.4 / 7.3 TR6 (SF99722 niveau 19) est la possibilité de déployer des services web (REST uniquement) basés sur des instructions SQL au lieu de programmes ILE.
Voici nos premiers tests, effectués « à vue » la documentation IBM n’étant pas encore disponible …
Services REST SQL
En bref, vous avez désormais les possibilités suivantes :
- effectuer des SELECT, UPDATE, INSERT
- appeler des fonctions SQL utilisateur (UDF), des fonctions tables (UDTF)
- appeler des procédures stockées (procédures cataloguées)
- utiliser directement la syntaxe VALUES …
- …
- retourner des données BINAIRES (images, pdf, …)
De plus, IWS vous propose également un format de sortie HTML, en plus de JSON et XML déjà en place. De quoi faciliter l’intégration de vos données dans des pages web !
Comment fait-on ?
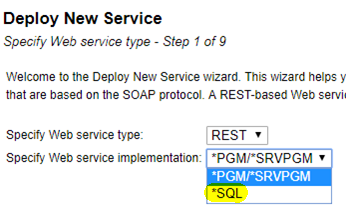
Déployer un nouveau service : vos avez maintenant la possibilité de choisir SQL
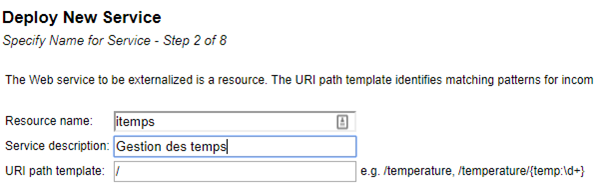
Comme d’habitude pour les services REST, vous indiquez nom de service et nom de ressource
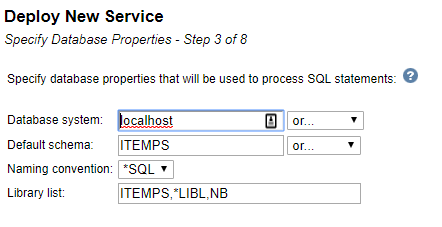
Maintenant, vous avez des paramètres spécifiques à un service basé sur SQL vous permettant de régler les conventions de nommage et la résolution des objets non qualifiés dans vos requêtes. Le fonctionnement est habituel en SQL. Pour simplifier : basé sur la *LIBL en convention *SYS, sur un schéma par défaut en *SQL
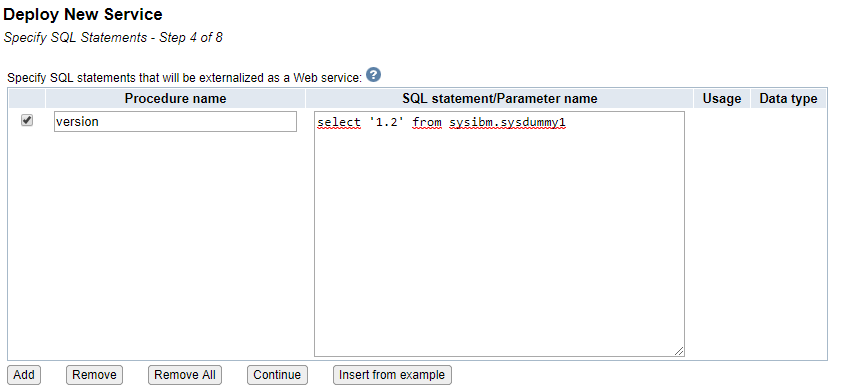
Vous pouvez indiquer plusieurs « procédures » dans un service REST SQL, c’est à dire plusieurs opérations disponibles au travers de votre service, et identifiées (plus tard) par des URL et/ou des méthodes HTTP différentes
Pour commencer simplement :
Bien sûr, vous pouvez utiliser des paramètres dans vos requêtes SQL, identifiés par « ? » :
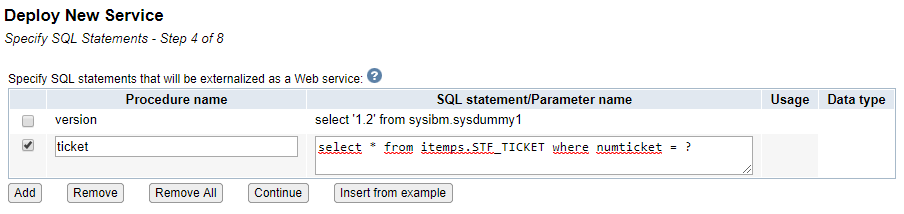
L’outil est plutôt bien fait de ce côté-là : il est capable de détecter le type des données correspondant à vos paramètres en analysant le fichier :

Vous devez ensuite régler le comportement attendu de votre traitement :
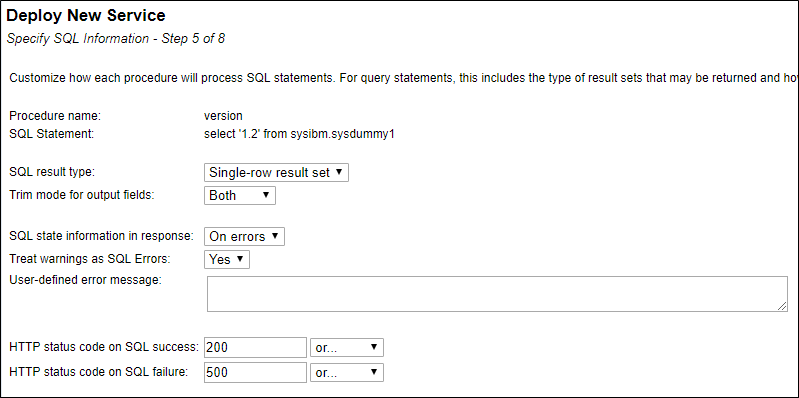
la suite des écrans est classique et ne présente pas de particularité dû au SQL, en dehors du type de sortie *HTML proposé.
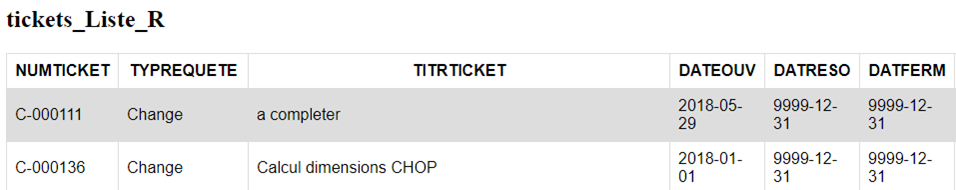
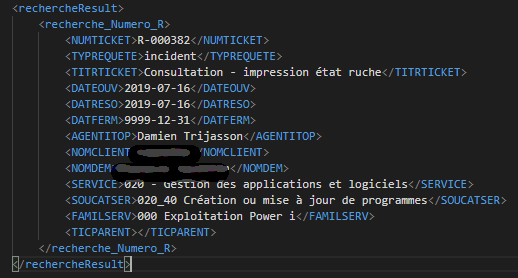
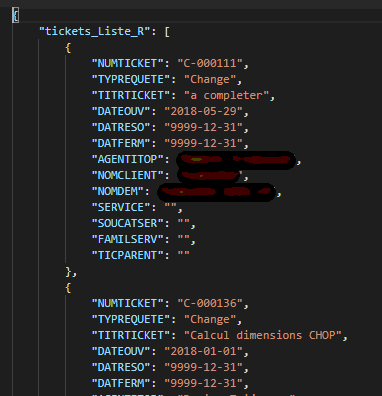
Quelques exemples de résultats fournis par les appels de différents services (renvoyant une ligne ou plusieurs lignes, en JSON, en XML, en HTML …) :
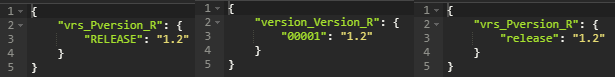
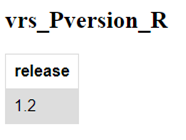
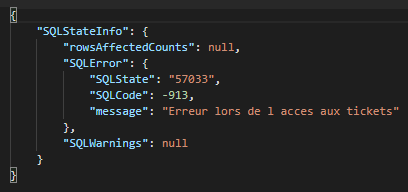
L’outil vous permet également d’obtenir des informations sur l’exécution et les erreurs SQL :
Données binaires
Maintenant, passons à la possibilité qui ouvre d’autres perspectives !
Avec les services basés sur des programmes ILE RPG/COBOL, nous n’arrivons pas à retourner des images ou documents binaires : toutes les données sont converties en UTF-8 (par défaut) pour sortir sur le flux HTTP. Nos données binaires ne supportent pas bien … seule solution jusqu’ici : encoder en base64 (c’est à dire en caractères) ! Mais cela complexifie, nécessite du temps machine et augmente la taille de la sortie.
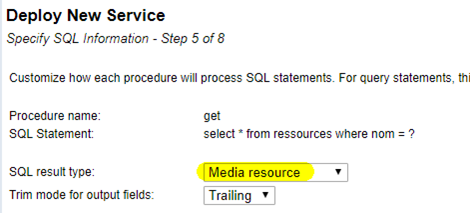
Lors du déploiement, sélectionner le type « Media resource »
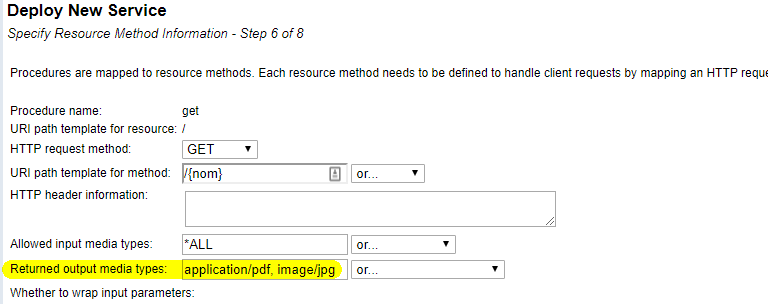
Vous devez indiquer le type de ressource (seule la première valeur est prise en compte) :
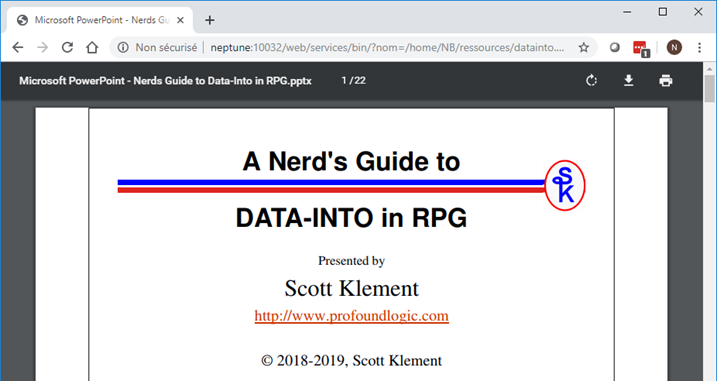
Dès lors, vos services web peuvent retourner des documents (au sens large), par exemple un pdf accessible depuis un navigateur :
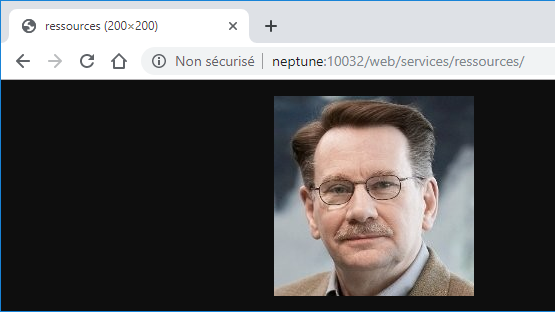
Ou une image (vous devriez reconnaître) :
Adaptation des scripts shell
Un nouveau script shell a fait son apparition dans /qibm/proddata/os/webservices/bin : getConfigurationFile.sh
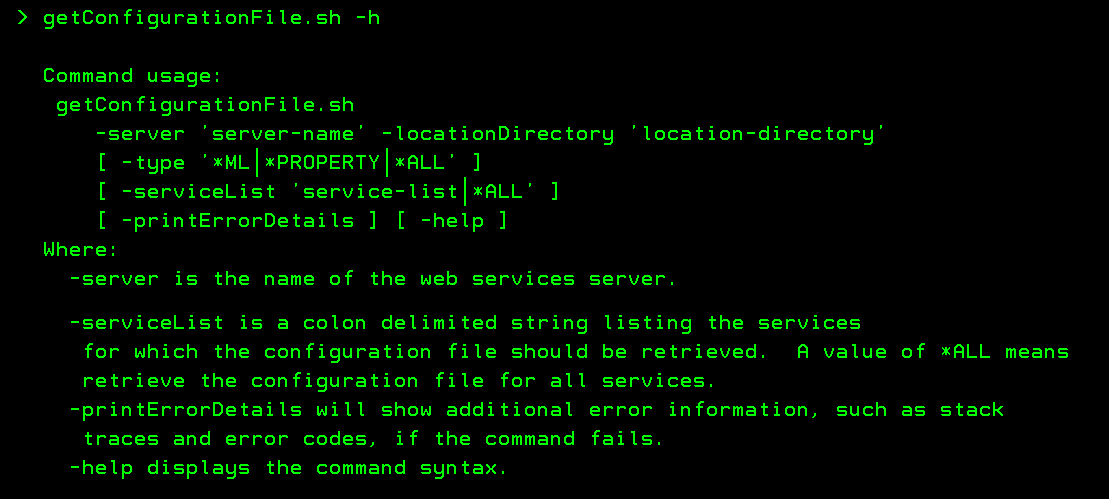
Les informations disponibles actuellement : https://www.ibm.com/developerworks/community/wikis/home?lang=en#!/wiki/dW%20IBM%20Integrated%20Web%20Services%20for%20i/page/Script%20to%20generate%20property%20file%20for%20a%20service
Ce dernier génère deux fichiers pour un service :
- un fichier .properties
- un fichier .xml
Le fichier properties contient les attributs du service, des procédures/méthodes, du connecteur jdbc.
Le fichier xml est en réalité un fichier pcml contenant des balises spécifiques utilisées pour le déploiement d’un service.
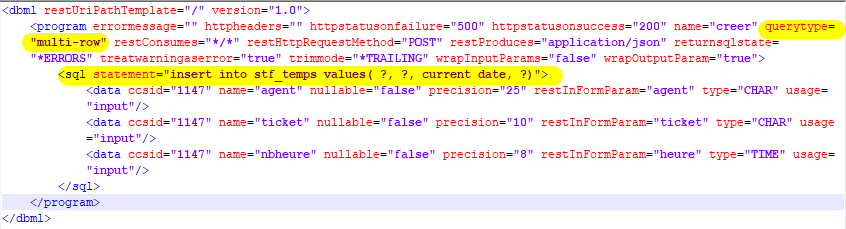
Ces formats de fichiers permettront également le déploiement par script shell (avec installWebService.sh) des services REST SQL.
En conclusion
L’outil poursuit sa belle évolution, avec toujours plus de fonctionnalités et de possibilités ! Nous compléterons prochainement avec des tests plus approfondis.
D’ici là, bonnes vacances à tous, et rendez-vous à la rentrée, reposé et bronzé !
Une des fonctionnalités attendues disponible avec la 7.4 / 7.3 TR6 (SF99722 niveau 19) est la possibilité de déployer des services web (REST uniquement) basés sur des instructions SQL au lieu de programmes ILE.
Voici nos premiers tests, effectués « à vue » la documentation IBM n’étant pas encore disponible …
Services REST SQL
En bref, vous avez désormais les possibilités suivantes :
De plus, IWS vous propose également un format de sortie HTML, en plus de JSON et XML déjà en place. De quoi faciliter l’intégration de vos données dans des pages web !
Comment fait-on ?
Déployer un nouveau service : vos avez maintenant la possibilité de choisir SQL
Comme d’habitude pour les services REST, vous indiquez nom de service et nom de ressource
Maintenant, vous avez des paramètres spécifiques à un service basé sur SQL vous permettant de régler les conventions de nommage et la résolution des objets non qualifiés dans vos requêtes. Le fonctionnement est habituel en SQL. Pour simplifier : basé sur la *LIBL en convention *SYS, sur un schéma par défaut en *SQL
Vous pouvez indiquer plusieurs « procédures » dans un service REST SQL, c’est à dire plusieurs opérations disponibles au travers de votre service, et identifiées (plus tard) par des URL et/ou des méthodes HTTP différentes
Pour commencer simplement :
Bien sûr, vous pouvez utiliser des paramètres dans vos requêtes SQL, identifiés par « ? » :
L’outil est plutôt bien fait de ce côté-là : il est capable de détecter le type des données correspondant à vos paramètres en analysant le fichier :
Vous devez ensuite régler le comportement attendu de votre traitement :
la suite des écrans est classique et ne présente pas de particularité dû au SQL, en dehors du type de sortie *HTML proposé.
Quelques exemples de résultats fournis par les appels de différents services (renvoyant une ligne ou plusieurs lignes, en JSON, en XML, en HTML …) :
L’outil vous permet également d’obtenir des informations sur l’exécution et les erreurs SQL :
Données binaires
Maintenant, passons à la possibilité qui ouvre d’autres perspectives !
Avec les services basés sur des programmes ILE RPG/COBOL, nous n’arrivons pas à retourner des images ou documents binaires : toutes les données sont converties en UTF-8 (par défaut) pour sortir sur le flux HTTP. Nos données binaires ne supportent pas bien … seule solution jusqu’ici : encoder en base64 (c’est à dire en caractères) ! Mais cela complexifie, nécessite du temps machine et augmente la taille de la sortie.
Lors du déploiement, sélectionner le type « Media resource »
Vous devez indiquer le type de ressource (seule la première valeur est prise en compte) :
Dès lors, vos services web peuvent retourner des documents (au sens large), par exemple un pdf accessible depuis un navigateur :
Ou une image (vous devriez reconnaître) :
Adaptation des scripts shell
Un nouveau script shell a fait son apparition dans /qibm/proddata/os/webservices/bin : getConfigurationFile.sh
Les informations disponibles actuellement : https://www.ibm.com/developerworks/community/wikis/home?lang=en#!/wiki/dW%20IBM%20Integrated%20Web%20Services%20for%20i/page/Script%20to%20generate%20property%20file%20for%20a%20service
Ce dernier génère deux fichiers pour un service :
Le fichier properties contient les attributs du service, des procédures/méthodes, du connecteur jdbc.
Le fichier xml est en réalité un fichier pcml contenant des balises spécifiques utilisées pour le déploiement d’un service.
Ces formats de fichiers permettront également le déploiement par script shell (avec installWebService.sh) des services REST SQL.
En conclusion
L’outil poursuit sa belle évolution, avec toujours plus de fonctionnalités et de possibilités ! Nous compléterons prochainement avec des tests plus approfondis.
D’ici là, bonnes vacances à tous, et rendez-vous à la rentrée, reposé et bronzé !
Contrôler ses données avec SQL as a service
L’arrivée de la function table joblog_info qui permet de voir la log d’un travail ouvre de nouvelles manières de travailler.
En voici une qui va vous permettre de savoir si vous avez des données erronées dans vos fichiers PF.
Quand vous faites une requête avec un select sur un pf qui a des données en erreur, en fonction de votre interface vous obtenez des ++++ ou autres qui vous indique que vos données sont en erreur !
Mais surtout ça génère un message CPF5035 dans votre log qui vous indique la ligne et la zone en erreur
Exemple :
select substr(MESSA00007, 1, 10) as fichier ,
substr(MESSA00007, 21, 10) as biblio,
substr(MESSA00009, 55, 71) as texte
from table(qsys2.joblog_info(‘*’)) a
where MESSAGE_ID = ‘CPF5035’
Qui vous donnera
CLIENTS GAIA la zone CLIENTS_1.CAANC, numéro d’enreg 213, format *FIRST, membre
CLIENTS GAIA la zone CLIENTS_1.CAAN1, numéro d’enreg 213, format *FIRST, membre
CLIENTS GAIA la zone CLIENTS_1.CAAN2, numéro d’enreg 213, format *FIRST, membre
Ici on voit que sur l’enregistrement 213 (rang relatif) a des zones CAANC, CAAN1 et CAAN2 qui ont des données en erreur
Vous pouvez corriger facilement en faisant
update gaia.clients a set caanc = 0 where rrn(a) = 213
Voici un petit script CLLE qui vous permettra de savoir si un PF à des données en erreur
pgm parm(&table &lib)
dcl &table *char 10
dcl &lib *char 10
chkobj &lib/&table *file
RUNSQL SQL(‘drop table qtemp/wtest’) COMMIT(*NONE)
monmsg SQL9010
RUNSQL SQL(‘create table qtemp/wtest as (select * +
from’ *BCAT &LIB *TCAT ‘/’ *TCAT &TABLE +
*bcat ‘)with data’) COMMIT(*NONE)
monmsg SQL9010 exec(do)
/* ici votre traitement pour récupérer les erreurs CPF5035 */
/* select substr(MESSA00009, 55, 71) as texte */
/* from table(qsys2.joblog_info(‘*’)) a */
/* where MESSAGE_ID = ‘CPF5035’ */
/* vous devrez par exemple écrire ces données dans une table */
endpgm
Ce script est a améliorer en effet il ne donne que le premier enregistrement corrompu , sql interrompant le traitement à la première erreur.
Parser un tableau JSON avec l’opération SQL JSON_TABLE
L’opération SQL JSON_TABLE sert à extraire les données d’un flux JSON pour les intégrer en base de données.
Pour rappel, les services web REST renvoient la plupart du temps des réponses en JSON.
L’opération fonctionne bien si le premier niveau hiérarchique du flux est un objet JSON, pouvant lui-même contenir un tableau.
Prenons par exemple un flux JSON contenant l’objet « qteage » étant lui-même un tableau :
{
« qteage »: [
{
« agence »: « LY »,
« qte »: 567
},
{
« agence »: « PA »,
« qte »: 879
}
],
« code »: « OK »,
« message »: « »
}
Nous pouvons récupérer les éléments du tableau sans problème par la requête :
select u.* from json_table( ‘{
« qteage »: [
{
« agence »: « LY »,
« qte »: 567
},
{
« agence »: « PA »,
« qte »: 879
}
],
« code »: « OK »,
« message »: « »
}’, ‘strict $.qteage[*]’
COLUMNS( « CodAge » varchar(50) PATH ‘strict $.agence’ ,
« Quantite » decimal PATH ‘strict $.qte’
) ) AS U;
Par contre si le flux JSON renvoie directement un tableau, l’opération JSON_TABLE n’arrive plus à extraire les données :
Prenons par exemple, le flux suivant, qui est reconnu par les outils de validation en ligne :
Lorsque nous essayons de travailler avec ce flux, l’opération JSON_TABLE, ne fonctionne plus :
select u.* from json_table( ‘[
{
« agence »: « LY »,
« qte »: 567
},
{
« agence »: « PA »,
« qte »: 879
}
]’, ‘strict $.[*]’
COLUMNS( « CodAge » varchar(50) PATH ‘strict $.agence’ ,
« Quantite » decimal PATH ‘strict $.qte’
) ) AS U;
L’instruction est bien traitée, mais le résultat est vide :
IBM confirme que l’instruction attend un objet JSON et non un tableau sur le premier niveau hiérarchique.
Si vous êtes confronté à ce problème, vous n’aurez pas d’autre solution que de modifier le JSON reçu, pour ajouter un niveau hiérarchique qui englobera votre flux initial.
Par exemple par l’ajout de l’objet « data ». Votre flux deviendra :
{ « data » :
[
{
« agence »: « LY »,
« qte »: 567
},
{
« agence »: « PA »,
« qte »: 879
}
] }
Vous pouvez le faire, entre autre, par SQL :
SET :donnees = ‘{« data » : ‘ || trim(:donnees) || ‘}’ ;
Attention toutefois à l’encodage de votre résultat, le flux JSON d’origine est encodé en UTF8. Si le CCSID de votre machine est 65535, vous devrez modifier le CCSID de travail pour que l’instruction SQL s’exécute sans erreur, soit au niveau du job, de l’utilisateur, de variables de travail…. Mais là c’est une autre histoire !
Quid de SNA avec la version 7.4
La version 7.4 arrive, et une des grandes annonces est l’abandon de *ANYNET.
(*ANYNET est une solution qui permet d’encapsuler SNA dans de l’IP)
C’est l’occasion de faire le point sur SNA.
Pour les plus jeunes SNA est une implémentation réseau un peu comme TCP/IP ou ISO avec les quels il a de grandes similitudes.
C’est une solution propriétaire (IBM) qui existait avant TCP/IP qui tend à le remplacer.
Souvent les gens pensent ne plus utiliser SNA mais réalité ils l’utilisent encore.
Voici trois traces persistantes qu’on retrouvent chez nos clients
2) l’utilisation des fichiers stockés dans QFLR (plus connu sous le nom de dossier partagés)
3) l’utilisation des commandes SAVRST* qui permettent de distribuer des objets d’une machine à une autres.
Si vous utilisez une des 3 fonctions ne chercher pas vous êtes concernés.
Certes SNA ne semble pas être le sens de l’histoire, mais comment faire ?
Première Solution
il peut y avoir beaucoup de travail, par exemple OBJECT CONNECT n’a pas d’équivalent IP.
Plus besoin de faire un SAVDLO dans votre sauvegarde globale
Plus besoin de gérer la directory SNA
Faire des envois de mail avec des historiques et de vraies pièces jointes.
Deuxième Solution
Conclusion
Principales correspondances SNA / IP
Traquer les erreurs dans vos web services !
Génération des swaggers – mise à disposition d’une ptf corrective
Améliorez vos scripts SQL !
La toute dernière version de ACS disponible depuis novembre 2018 apporte son lot d’améliorations. Sans surprise, ce sont les fonctionnalités liées à SQL qui évoluent le plus.
Petite revue des principales évolutions.
Script SQL
Les SELECT avec l’option FOR UPDATE permettent une modification directement dans l’affichage du résultat :
Possibilité de demander l’affichage de l’entête de colonne, soit dans les options, soit par click droit sur l’entête dans le résultat :
Schéma de base de données
Le choix de l’ASP est désormais possible :
Des améliorations dans différents affichages (objets associés), et la capacité à modifier les Alias, Masque de colonne et Droits sur une ligne.
Autres
Dans le centre de performances SQL, possibilité de filtrer les moniteurs, les images instantanées de cache, et moniteurs d’événements de cache :
Dans les sessions 5250, la bufferisation du clavier est désactivable :
Les sessions 5250 Client Access configurées avec Kerberos sont prises en charge dans l’outil de migration.
Pour les transferts de fichier :
La version recommandée de Java est désormais Java 8 update 191 ou supérieur. Le script d’installation Windows vérifie la compatibilité avec la version de Java disponible sur le système.
La liste complète des dernières modifications : ftp://ftp.software.ibm.com/as400/products/clientaccess/solutions/readmespacs.txt
Toujours utile, les ressoucres ACS en ligne : https://www.ibm.com/developerworks/community/wikis/home?lang=en#!/wiki/IBM%20i%20Technology%20Updates/page/IBM%20i%20Access%20Resources
Utilisez node.js pour tester vos services web !
Retourner des documents grâce aux Web Services !
Vous êtes de plus en plus nombreux à utiliser IWS pour exposer des programmes (de service) ILE sous forme de service web ! Cette technique fonctionne bien : elle est simple, automatique, le code est écrit en RPG.
Mais utilisez vous toutes les possibilités fournies : XML ou JSON pour encapsuler les paramètres en sortie ?
De plus, nous sommes limités par le nombre de paramètres du code RPG :
Personnalisez vos services
Nous vous proposons aujourd’hui d’utiliser un type de media personnalisé en valeur de retour : vos services pourront retourner des documents de type XML, JSON, CSV, HTML, … en réalité tous les types usuels du web basés sur du texte.
Par exemple, la procédure suivante ramène les profils utilisateurs non système (la première lettre est différente de Q) et désactivés (une occasion de faire du ménage) :
Les paramètres :
Au déploiement du service vous devez indiquer certaines options :
On remarque :
Cette dernière option signifie que la valeur de retour sera toujours un document XML
Exemple lors de l’appel depuis un navigateur :
Ici le navigateur se base sur le type indiqué pour le retour (application/xml) pour mettre en forme le résultat.
Encore plus !
Nous pouvons maintenant aller plus loin en rendant dynamique les types de données en sortie !
Par exemple, une procédure permettant de lire un fichier sur l’IFS dont le nom est transmis en paramètre, et de retourner son contenu :
Le nom du fichier à retourner est reçu dans le paramètre file.
Nous gérons dans le tableau httpHeaders() la valeur du type de contenu en retour via une entête HTTP Content-Type. Les valeurs usuelles sont listées ici : https://en.wikipedia.org/wiki/Media_type
Le type de contenu est défini en fonction de l’extension du fichier : application/xml pour tous les fichiers *.xml.
Si une extension n’est pas connu du programme, nous provoquons une erreur HTTP 406 NOT ACCEPTABLE.
De plus, si le fichier n’est pas trouvé, un code HTTP 404 NOT FOUND est généré.
Lors du déploiement, il est également nécessaire d’indiquer certaines options :
Principalement dans « Returned output media types » -> doit contenir la liste de tous les types de médias retournées par le programme. Une valeur qui ne serait pas présente ici sera interceptée par le serveur IWS et provoquera une erreur HTTP 500 (Internal Server Error) et aucune valeur ne sera retournée.
Les différentes valeurs sont séparées par des virgules : application/xml, text/csv, text/html, text/plain.
Le swagger généré tient compte de ces informations pour une meilleur documentation et interopérabilité de vos services.
Lors des différents appels (les fichiers indiqués sur l’URL existent dans le répertoire /home/NB/ressources) :
Pour la gestion des cas d’erreur (extension non gérée ou fichier inexistant) :
Grâce à IWS, vos programmes RPG peuvent désormais facilement renvoyer tous types de documents, que le contenu soit statique (comme un fichier dans l’IFS) ou dynamique (calculé en live par votre programme). Et n’oubliez pas, DB2 offre de nombreuses possibilités (XML, JSON, accès à l’IFS …) qui sont donc directement utilisables en SQLRPGLE.
Prochaine étape : des fichiers binaires (image, pdf) !